Документация и руководство пользователя
Добро пожаловать в официальную документацию DataSynth Pro. Это подробное руководство содержит инструкции по настройке параметров для различных статистических модулей для синтеза надежных, академически обоснованных и статистически валидных наборов данных полностью офлайн.
1. Генерация нескольких показателей одновременно
1.1 Предварительные требования и запуск
Дважды щелкните исполняемый файл для запуска приложения. Программа требует Microsoft .NET 8.0 Runtime Framework. Если он не установлен на вашем компьютере, следуйте инструкциям для загрузки и установки, затем перезапустите программу.
Предупреждение безопасности: Если ваше антивирусное программное обеспечение помечает исполняемый файл как ложное срабатывание, добавьте его в список исключений или доверенных программ.
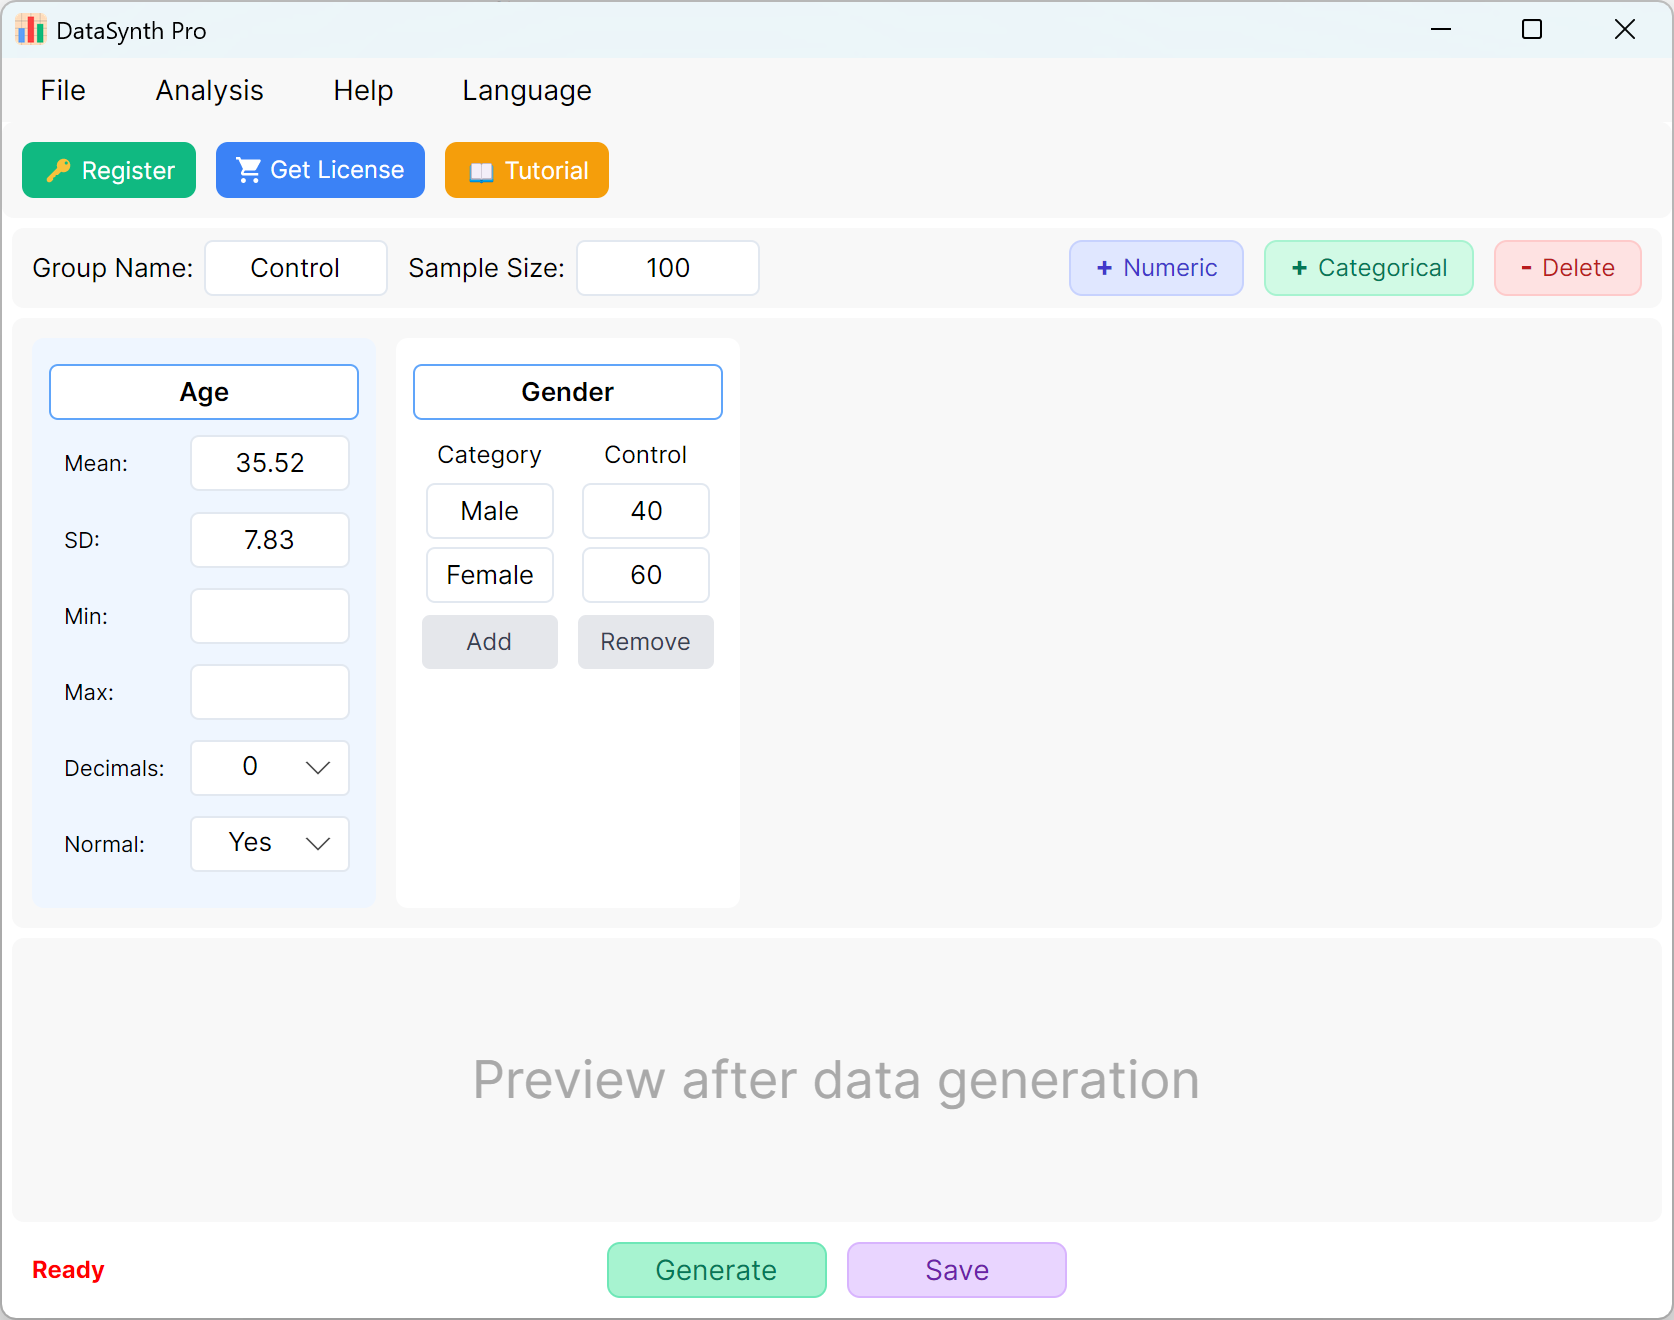
Рисунок 1.1: Главный интерфейс программы
1.2 Настройка параметров
По умолчанию приложение предварительно заполняет две непрерывные переменные: «Возраст» и «Пол» для быстрой справки. Группа по умолчанию называется «Контрольная группа», размер выборки установлен на 100 случаев. Если ваше исследование требует несколько групп, вы можете последовательно генерировать и экспортировать наборы данных для каждой группы, обновляя параметры для каждого запуска.
- Добавление непрерывных числовых переменных: Чтобы добавить новую количественную переменную, нажмите кнопку + Numeric. Затем укажите название показателя (например, «Индекс массы тела» или «ИМТ»), среднее значение, стандартное отклонение и количество десятичных знаков. Поля «Минимум» и «Максимум» необязательны.
- Настройки распределения данных: По умолчанию генерируемые числовые показатели следуют нормальному распределению. Если вам нужны данные с ненормальным распределением, установите опцию Normal Distribution в значение Нет.
Настройка распределения: Нормальное распределение основано на естественном диапазоне вариации; слишком строгие ограничения Минимума и Максимума обрежут нормальную кривую и могут привести к ненормально распределенным значениям.
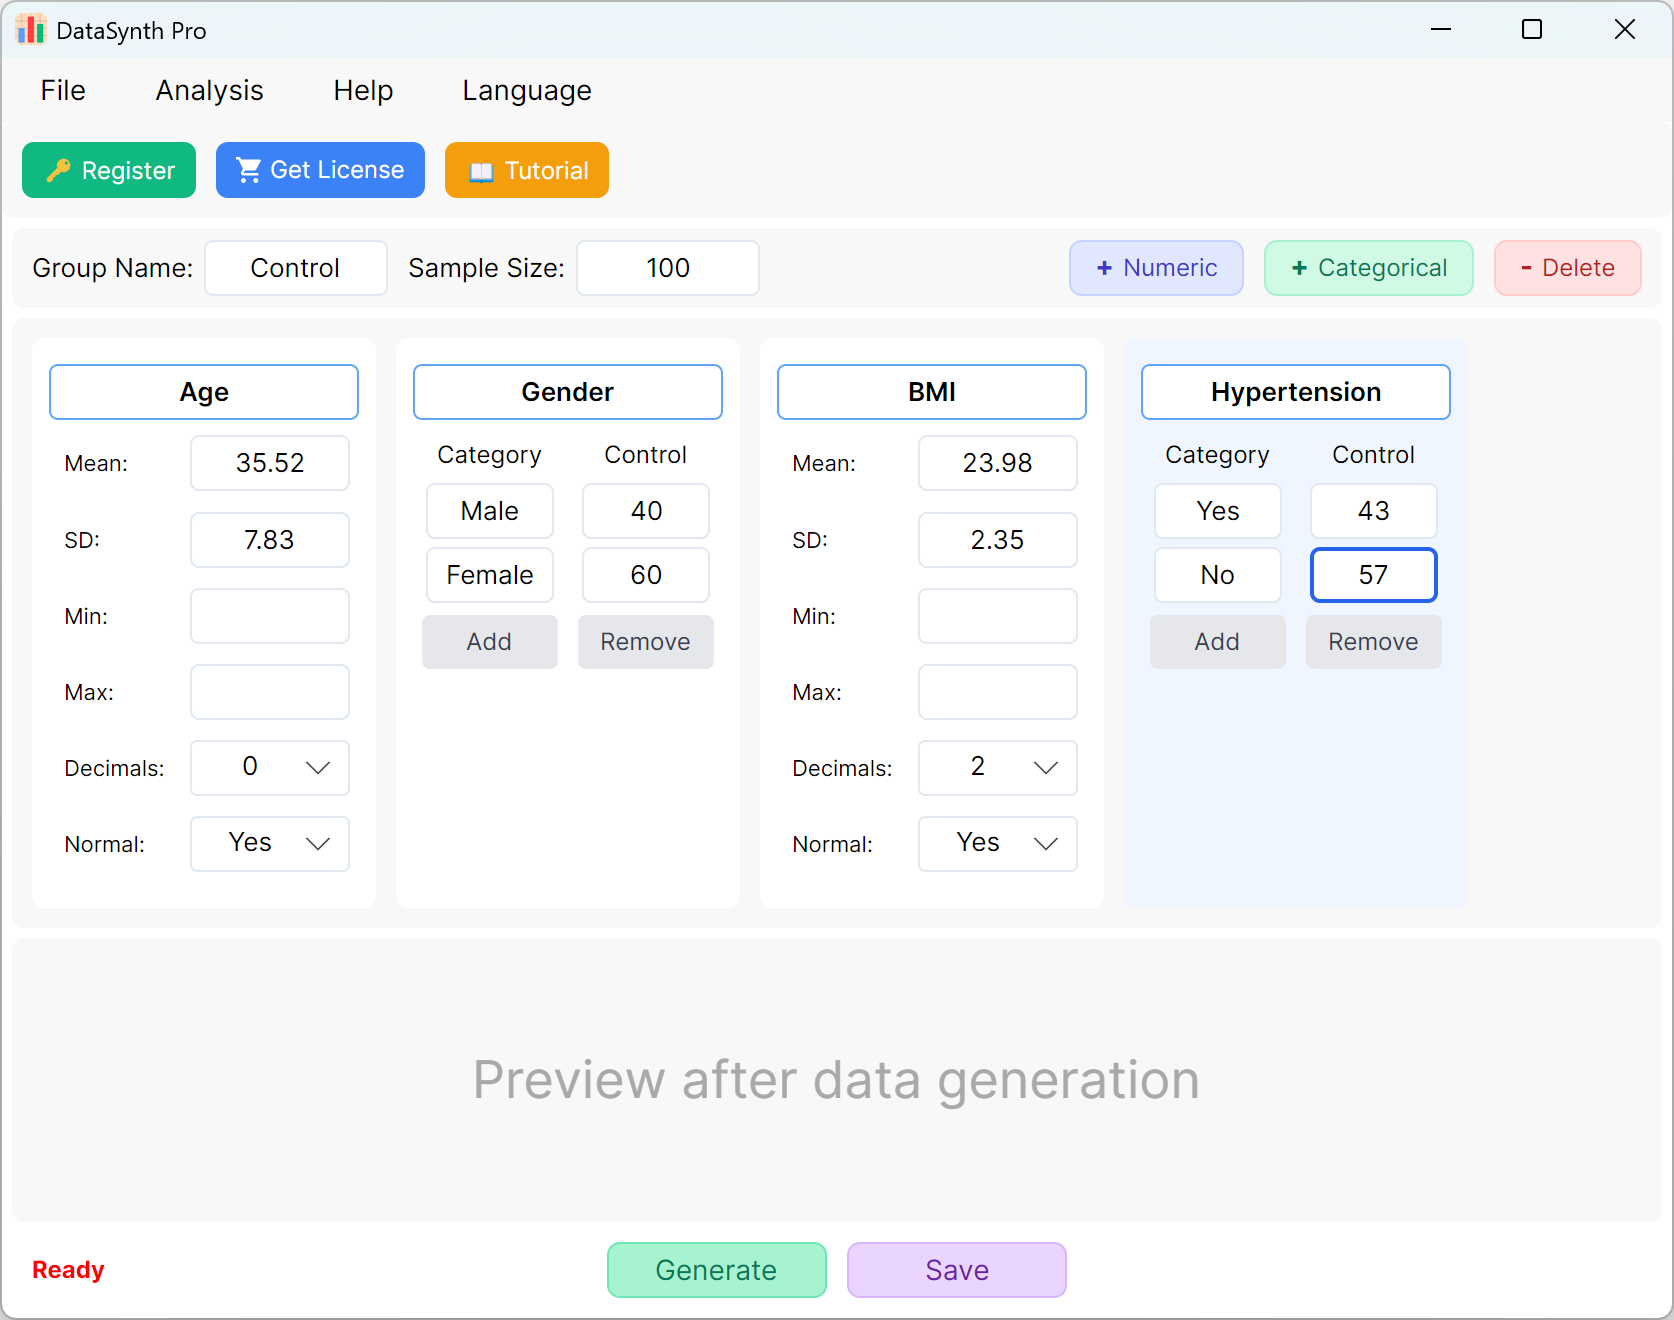
Рисунок 1.2: Добавление переменных
1.3 Добавление категориальных переменных
Нажмите кнопку + Categorical для добавления качественных переменных (например, «Гипертония»). Вы можете ввести названия категорий и соответствующие целевые распределения или пропорции.
1.4 Выполнение генерации
Нажмите кнопку Generate для синтеза заданного количества записей. После расчета появится окно сводной статистики, позволяющее проверить соответствие фактических сгенерированных значений заданным параметрам.
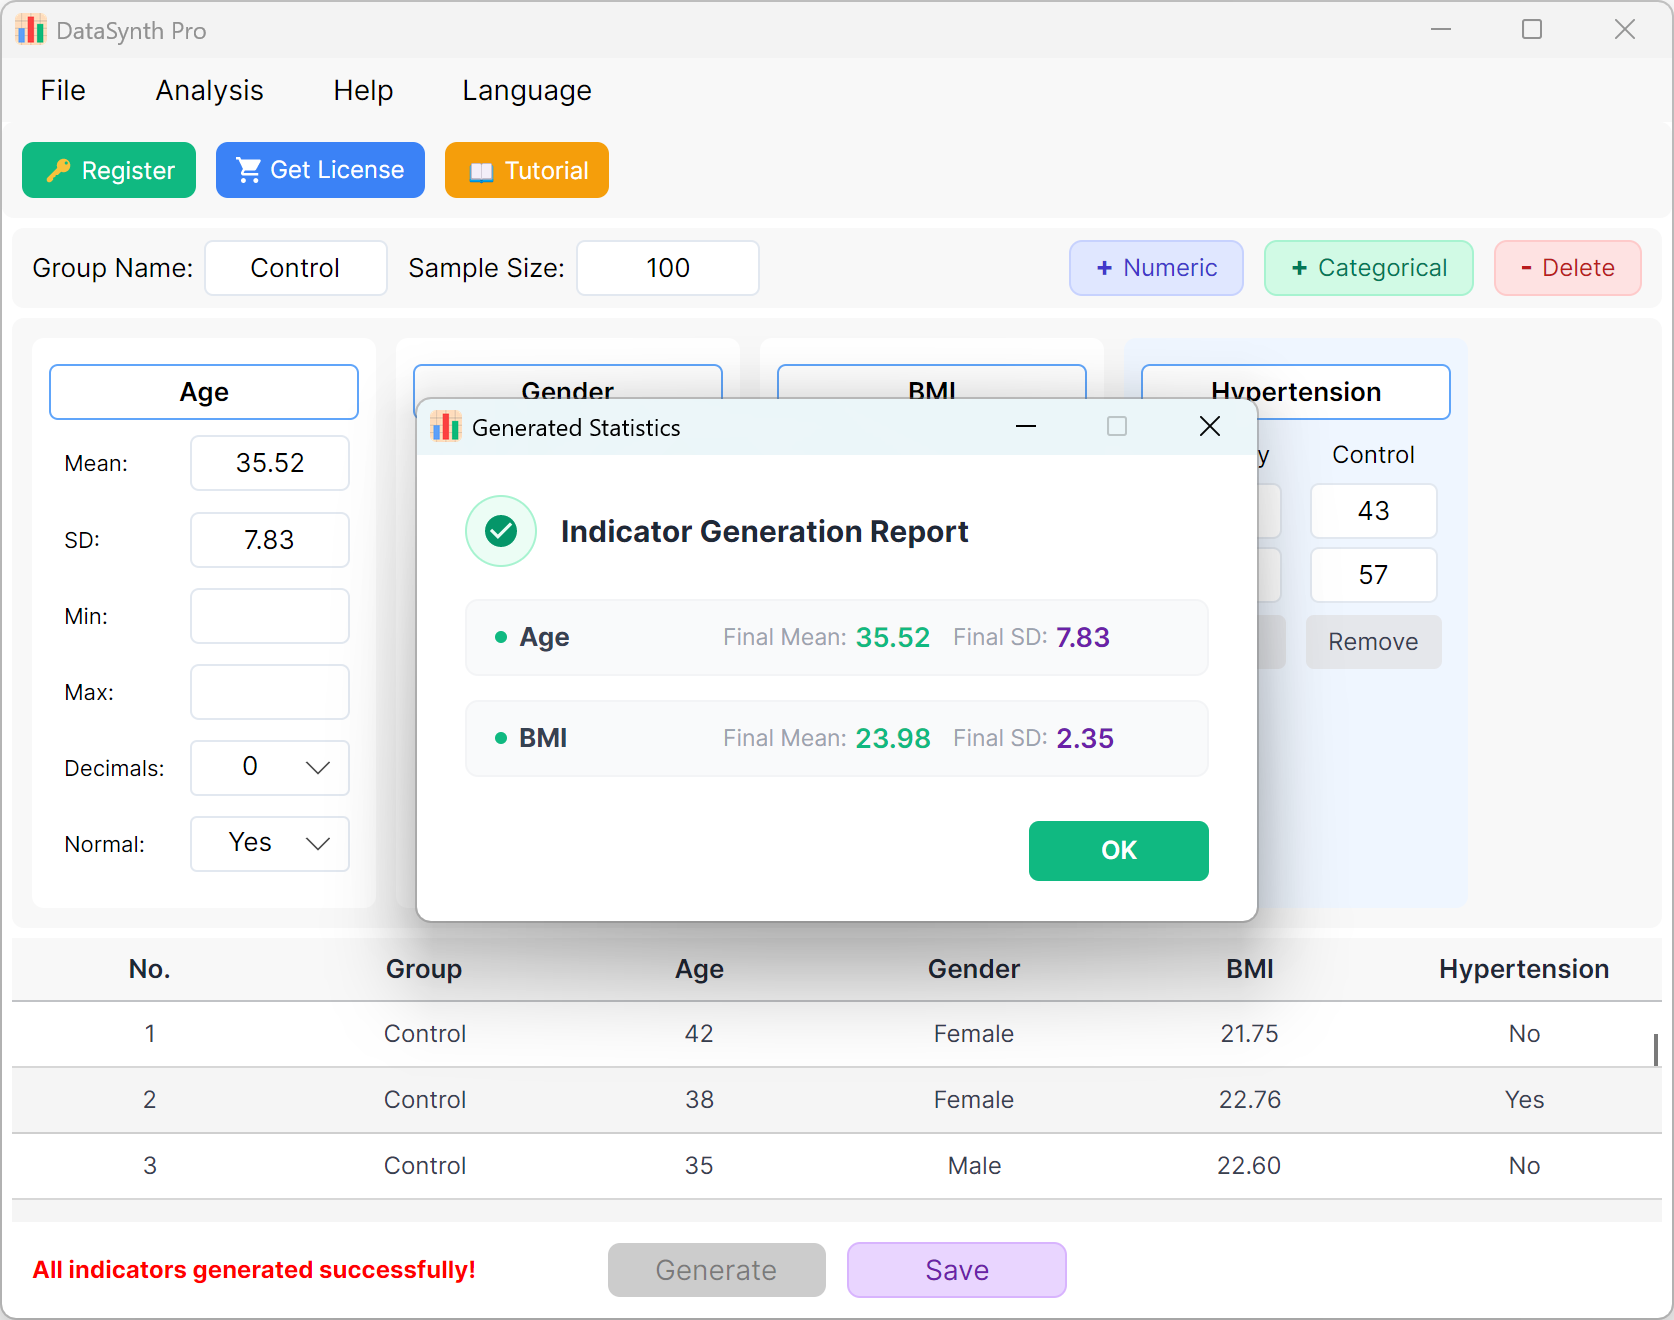
Рисунок 1.3: Выполнение генерации
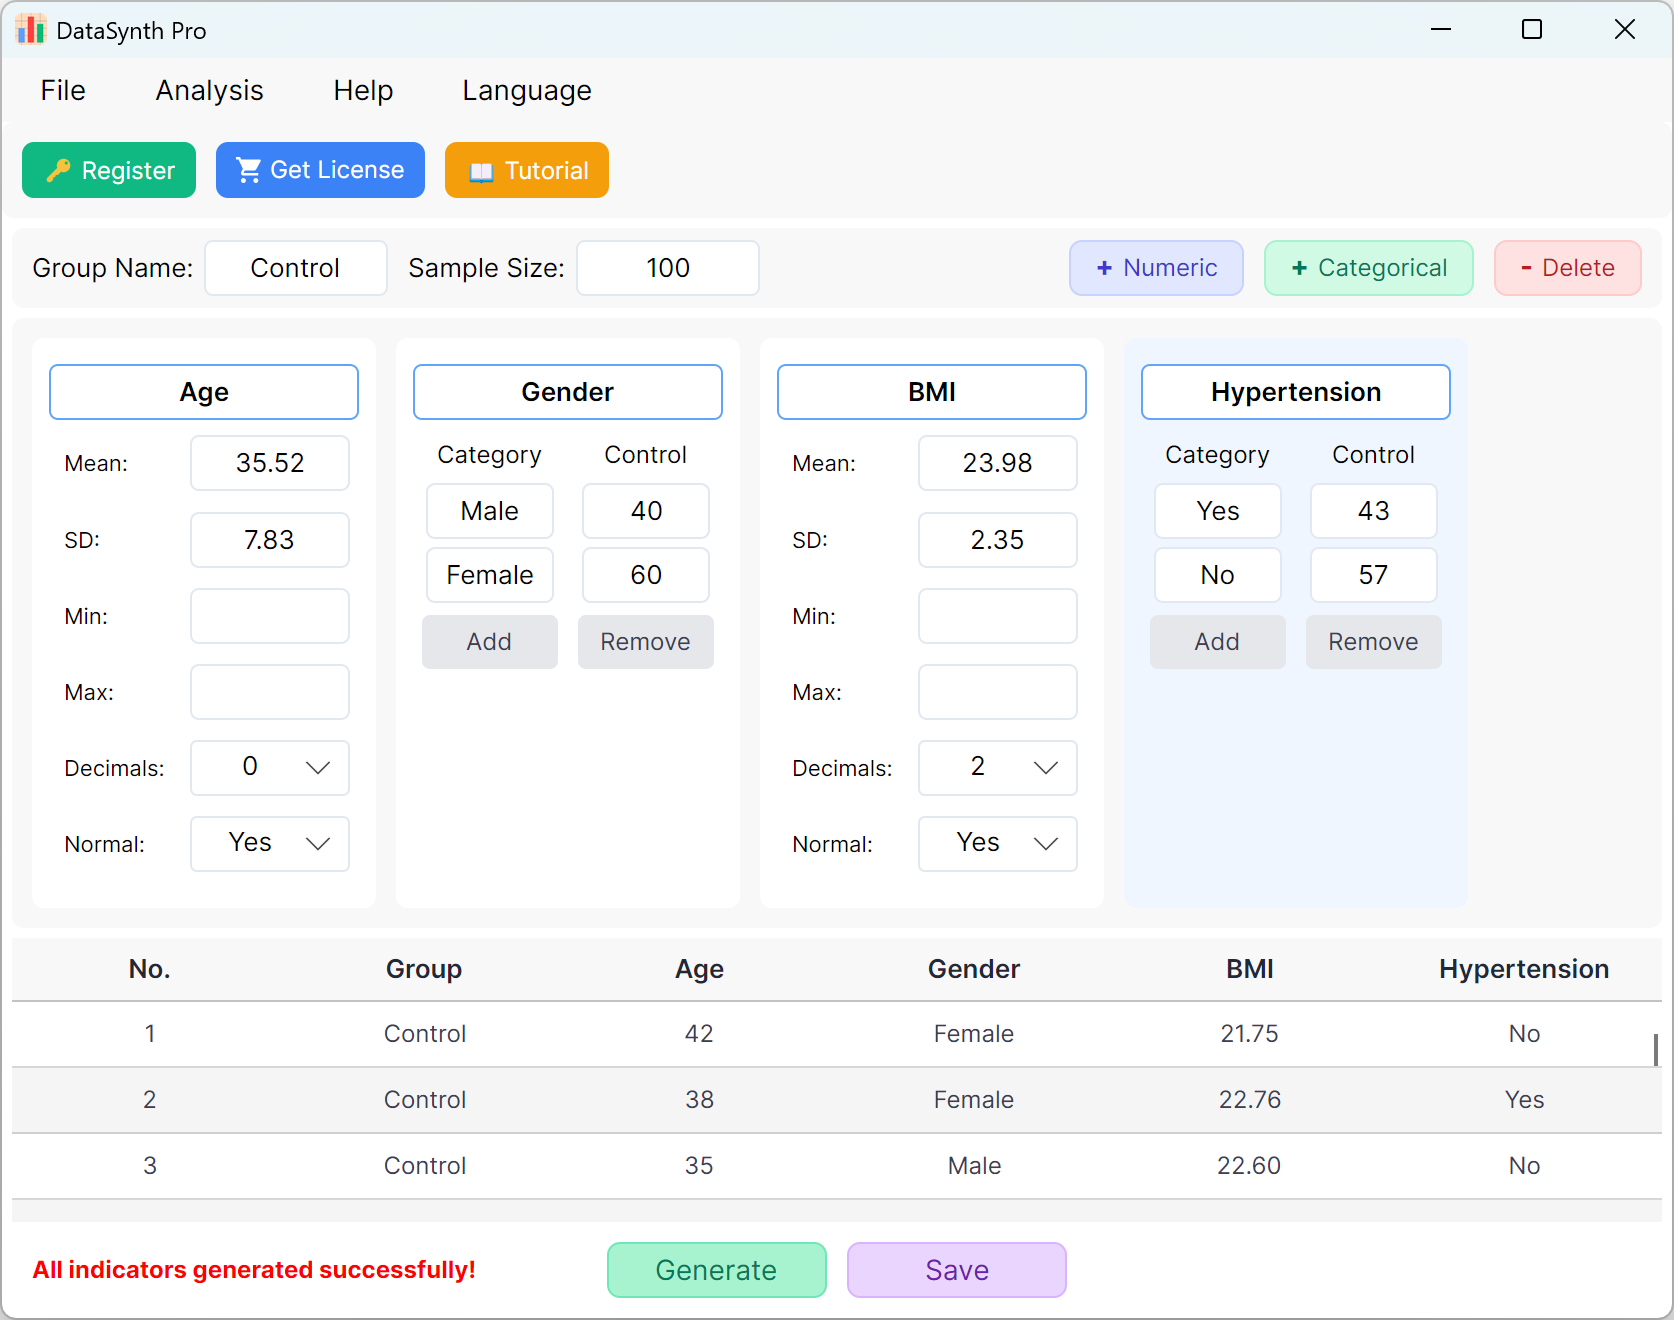
Рисунок 1.4: Отображение данных
1.5 Экспорт и проверка
Нажмите кнопку Save для экспорта сгенерированного набора данных в стандартный файл Excel.
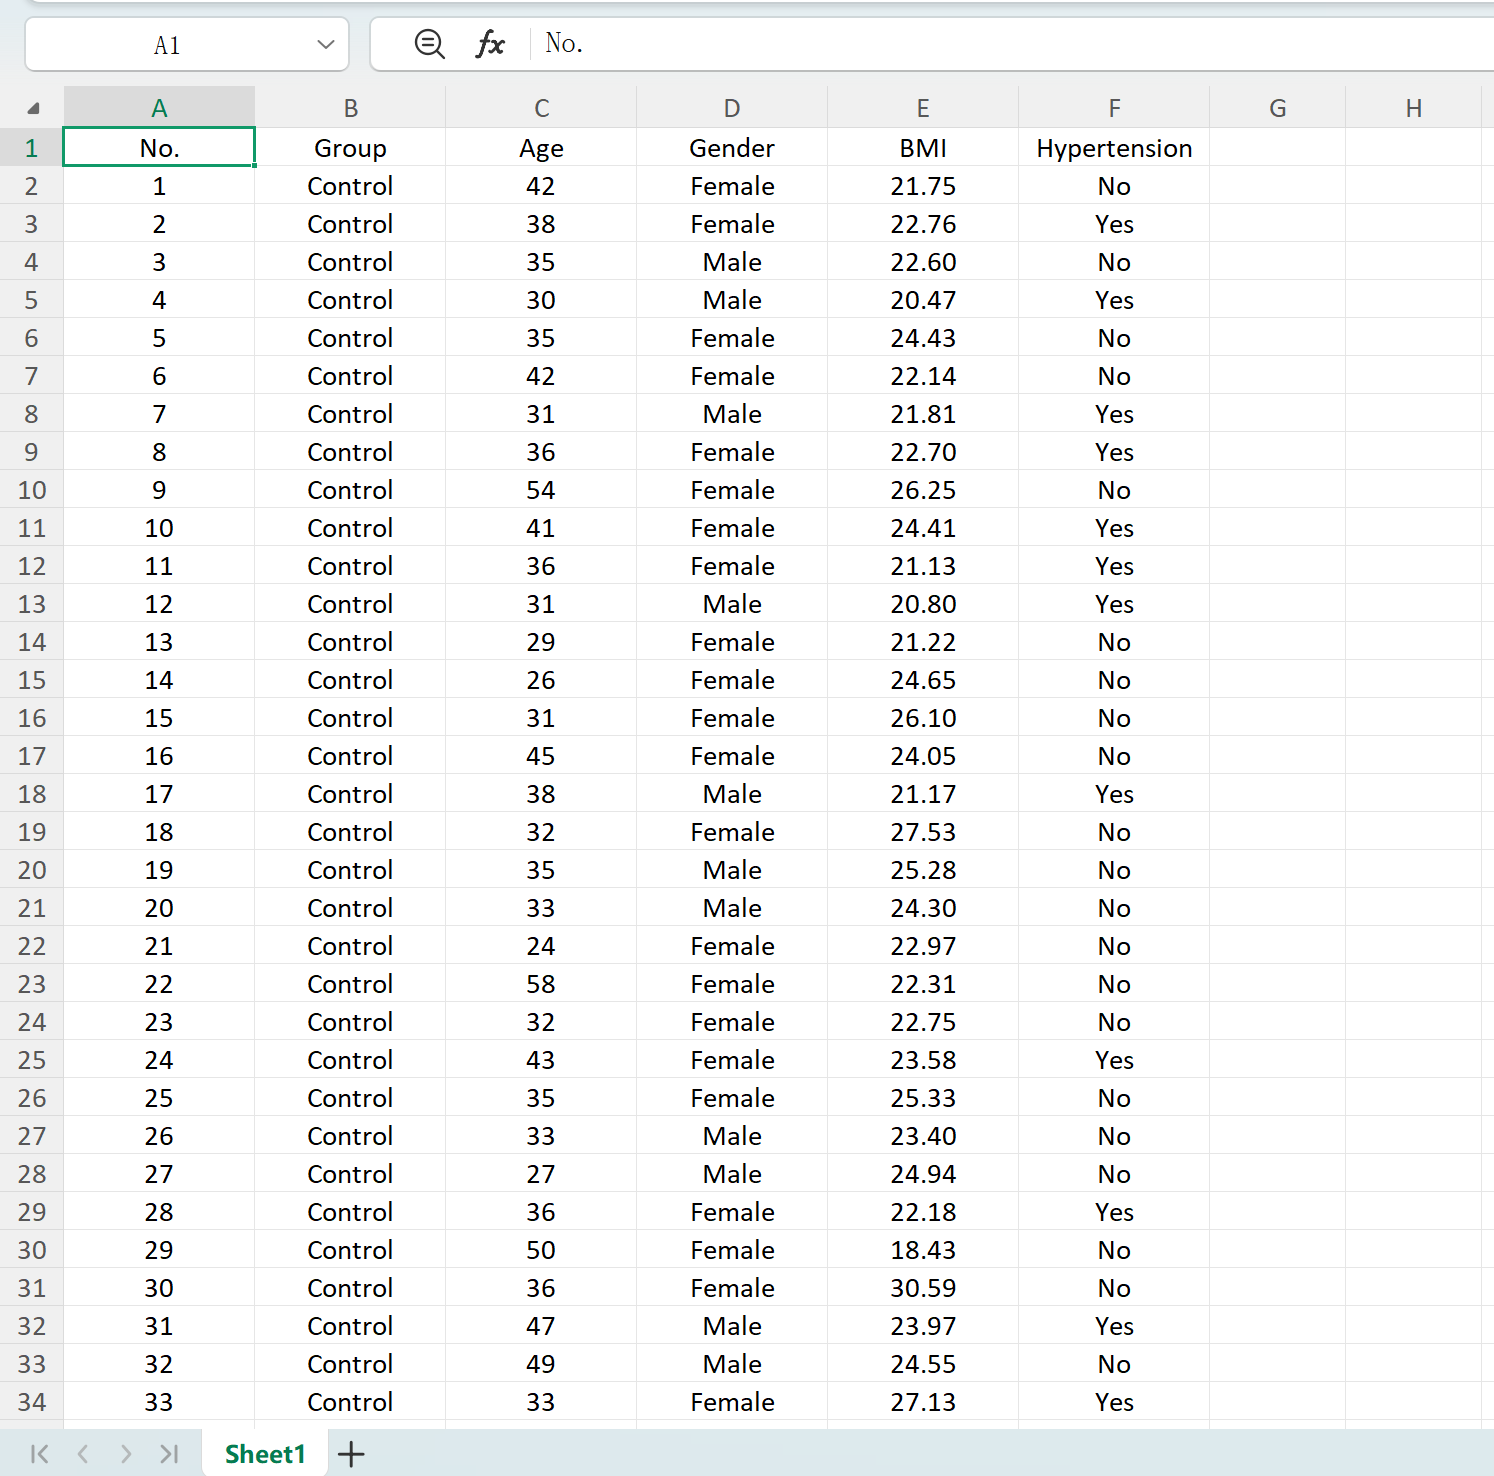
Рисунок 1.5: Экспорт таблиц в Excel
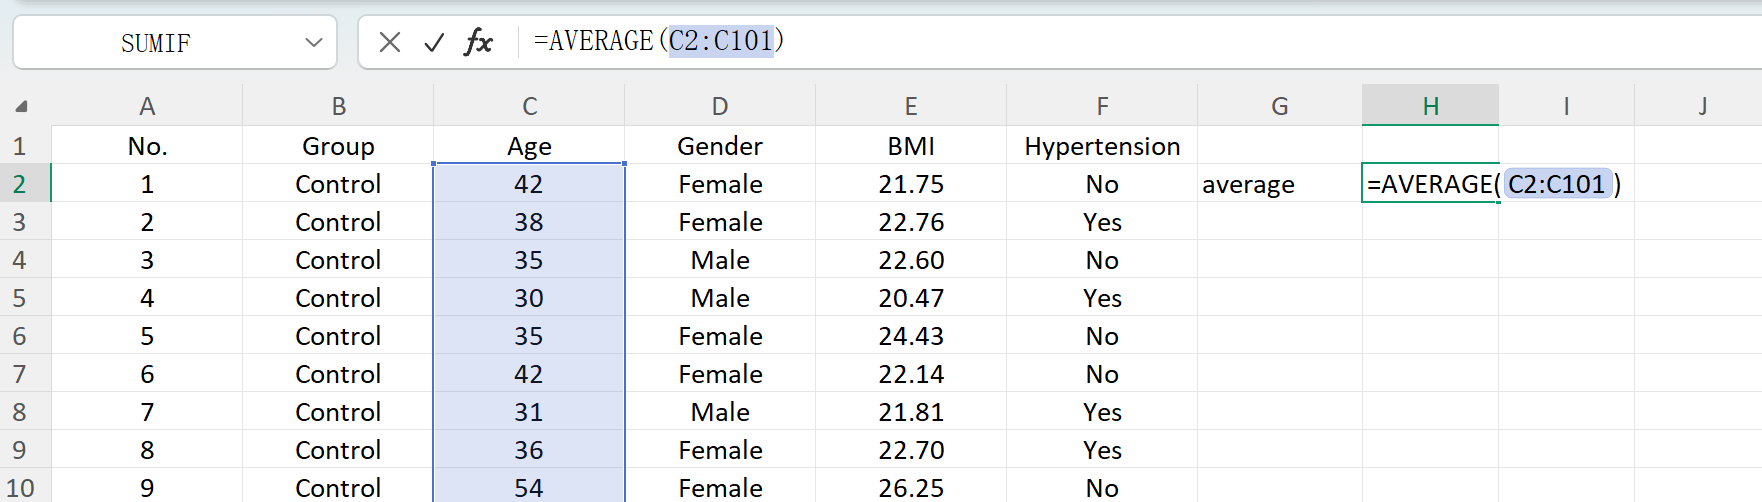
Рисунок 1.6: Вычисление среднего в Excel
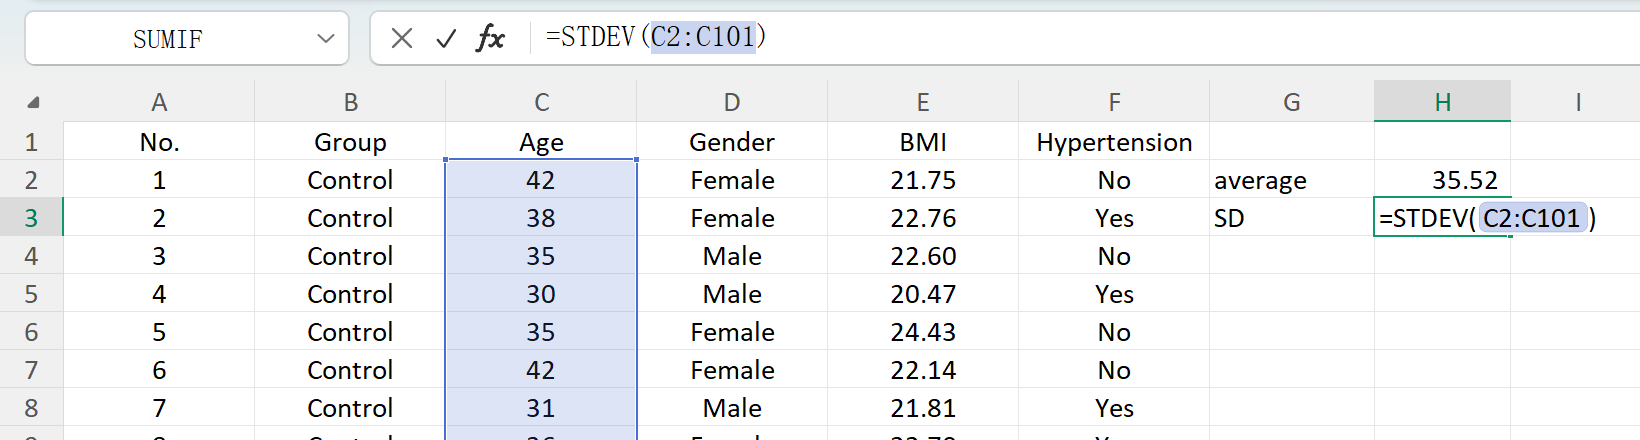
Рисунок 1.7: Вычисление стандартного отклонения в Excel
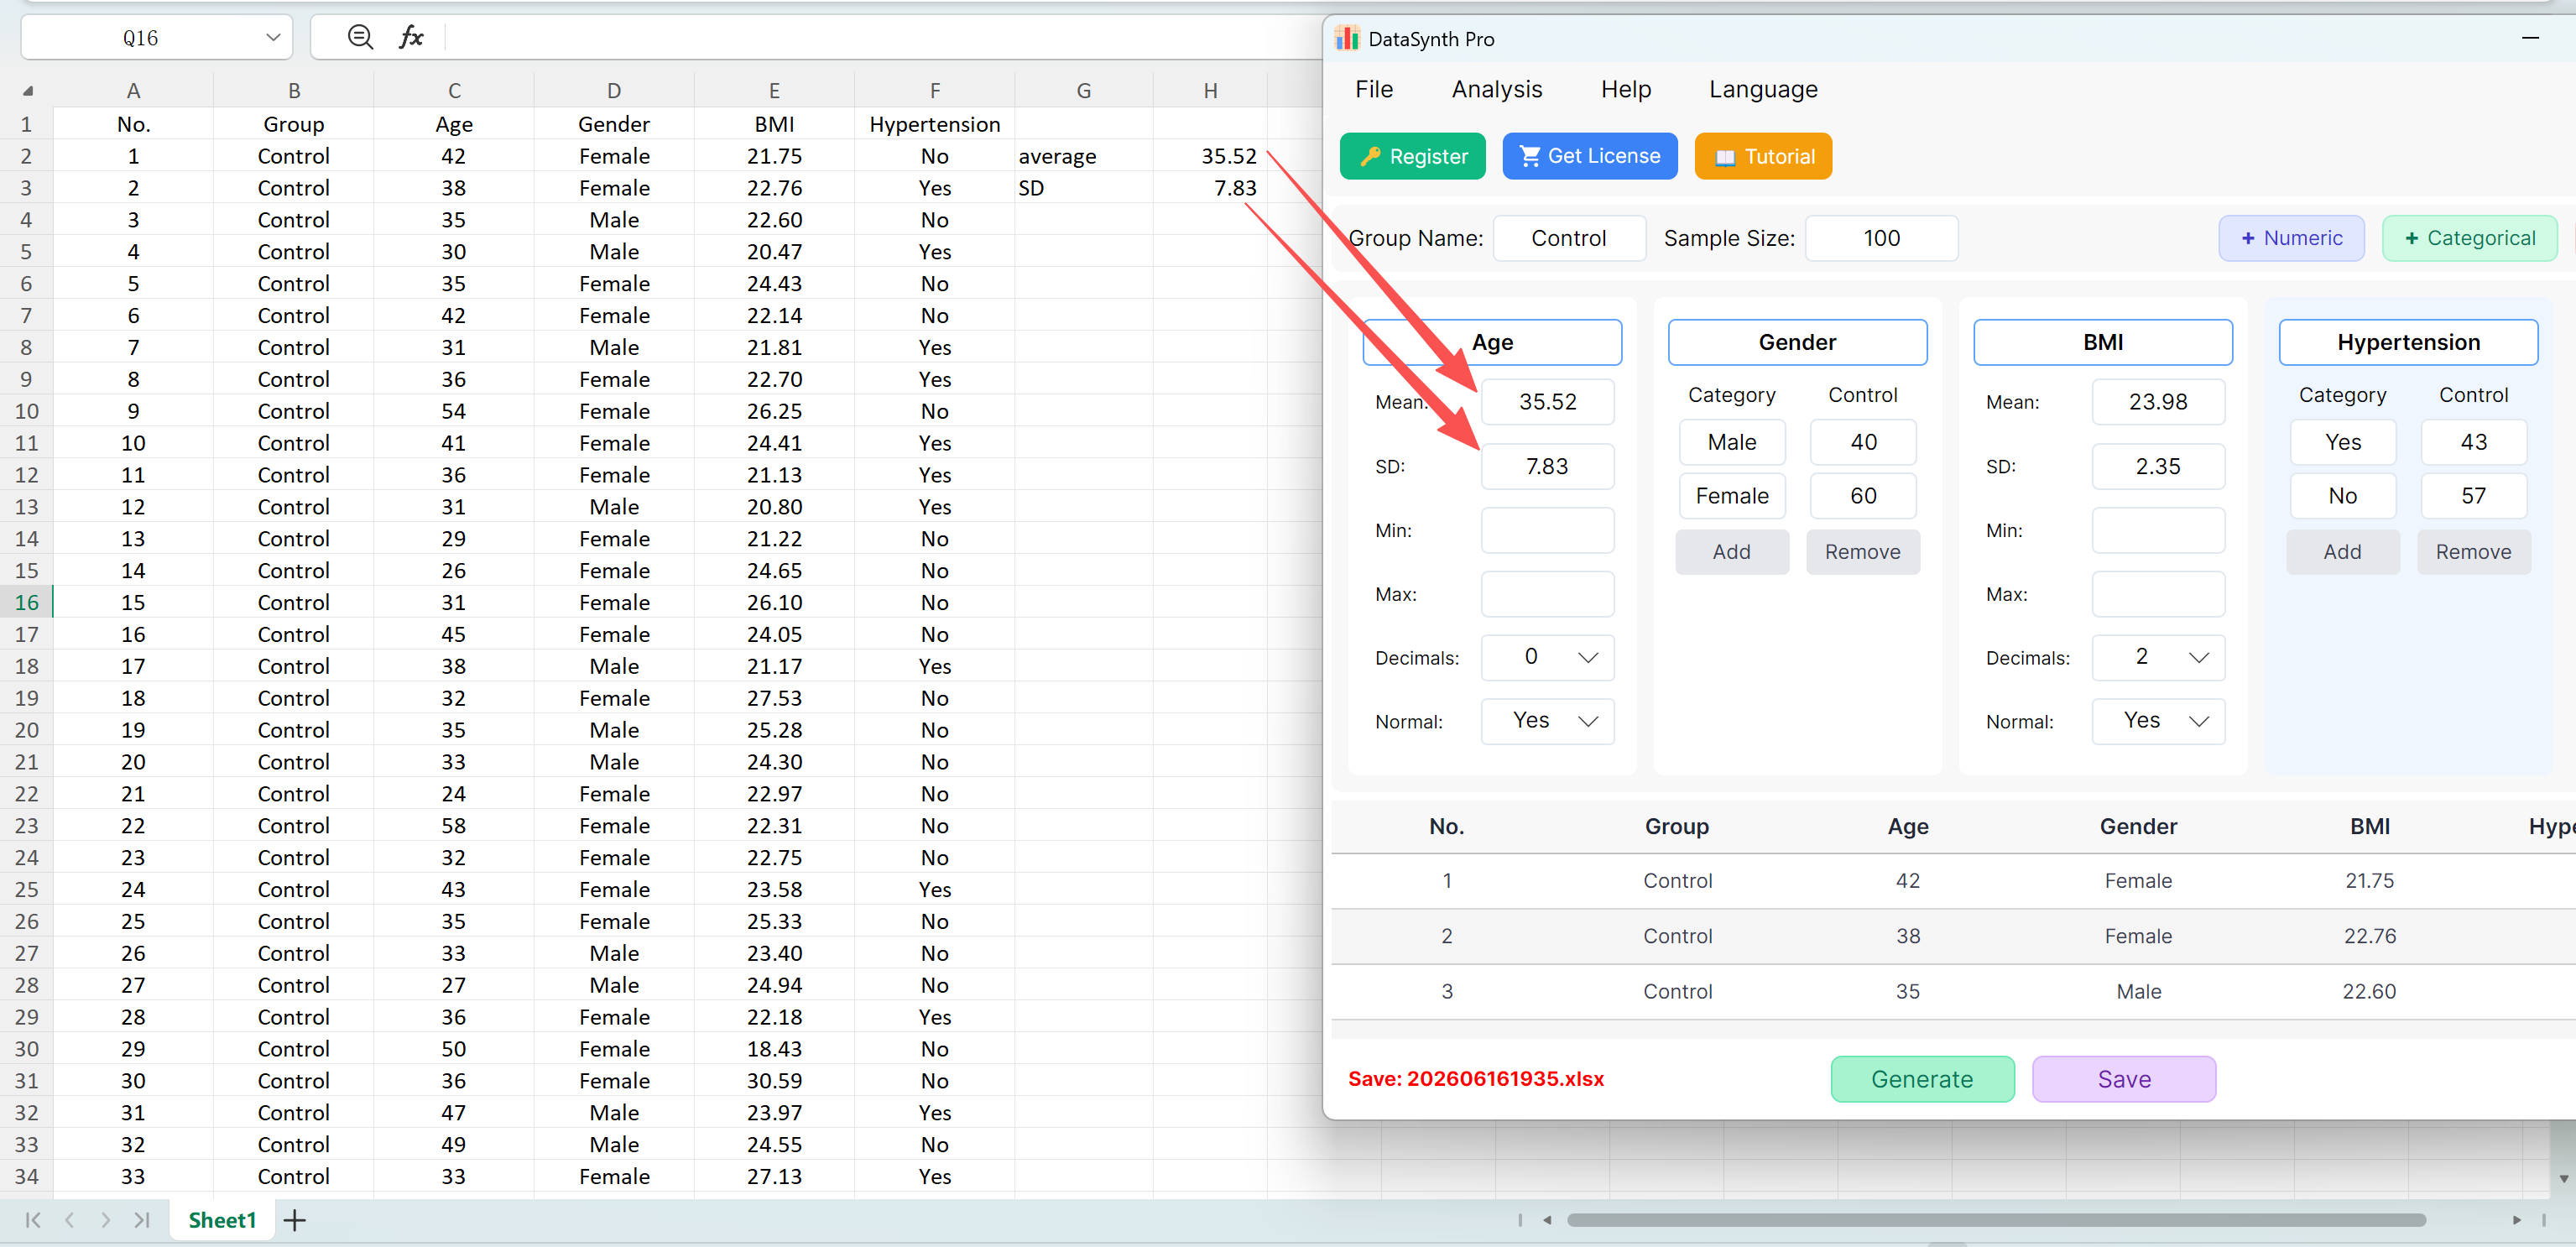
Рисунок 1.8: Результаты проверки совпадают с начальными настройками
1.6 Вычислительная эффективность
Оснащенный высокопроизводительным оптимизационным движком, программа может генерировать наборы данных, содержащие тысячи или десятки тысяч записей, за секунды.
Советы и рекомендации:
• Предпочтение нормального распределения: Данные по умолчанию соответствуют нормальному распределению для беспрепятственного последующего анализа.
2. Критерий Хи-квадрат
Определяет наличие значимой связи между двумя категориальными переменными. Широко используется для демографических кросс-табуляций.
4.1 Рабочий процесс
Перейдите в Analyze → Chi-Square Test.
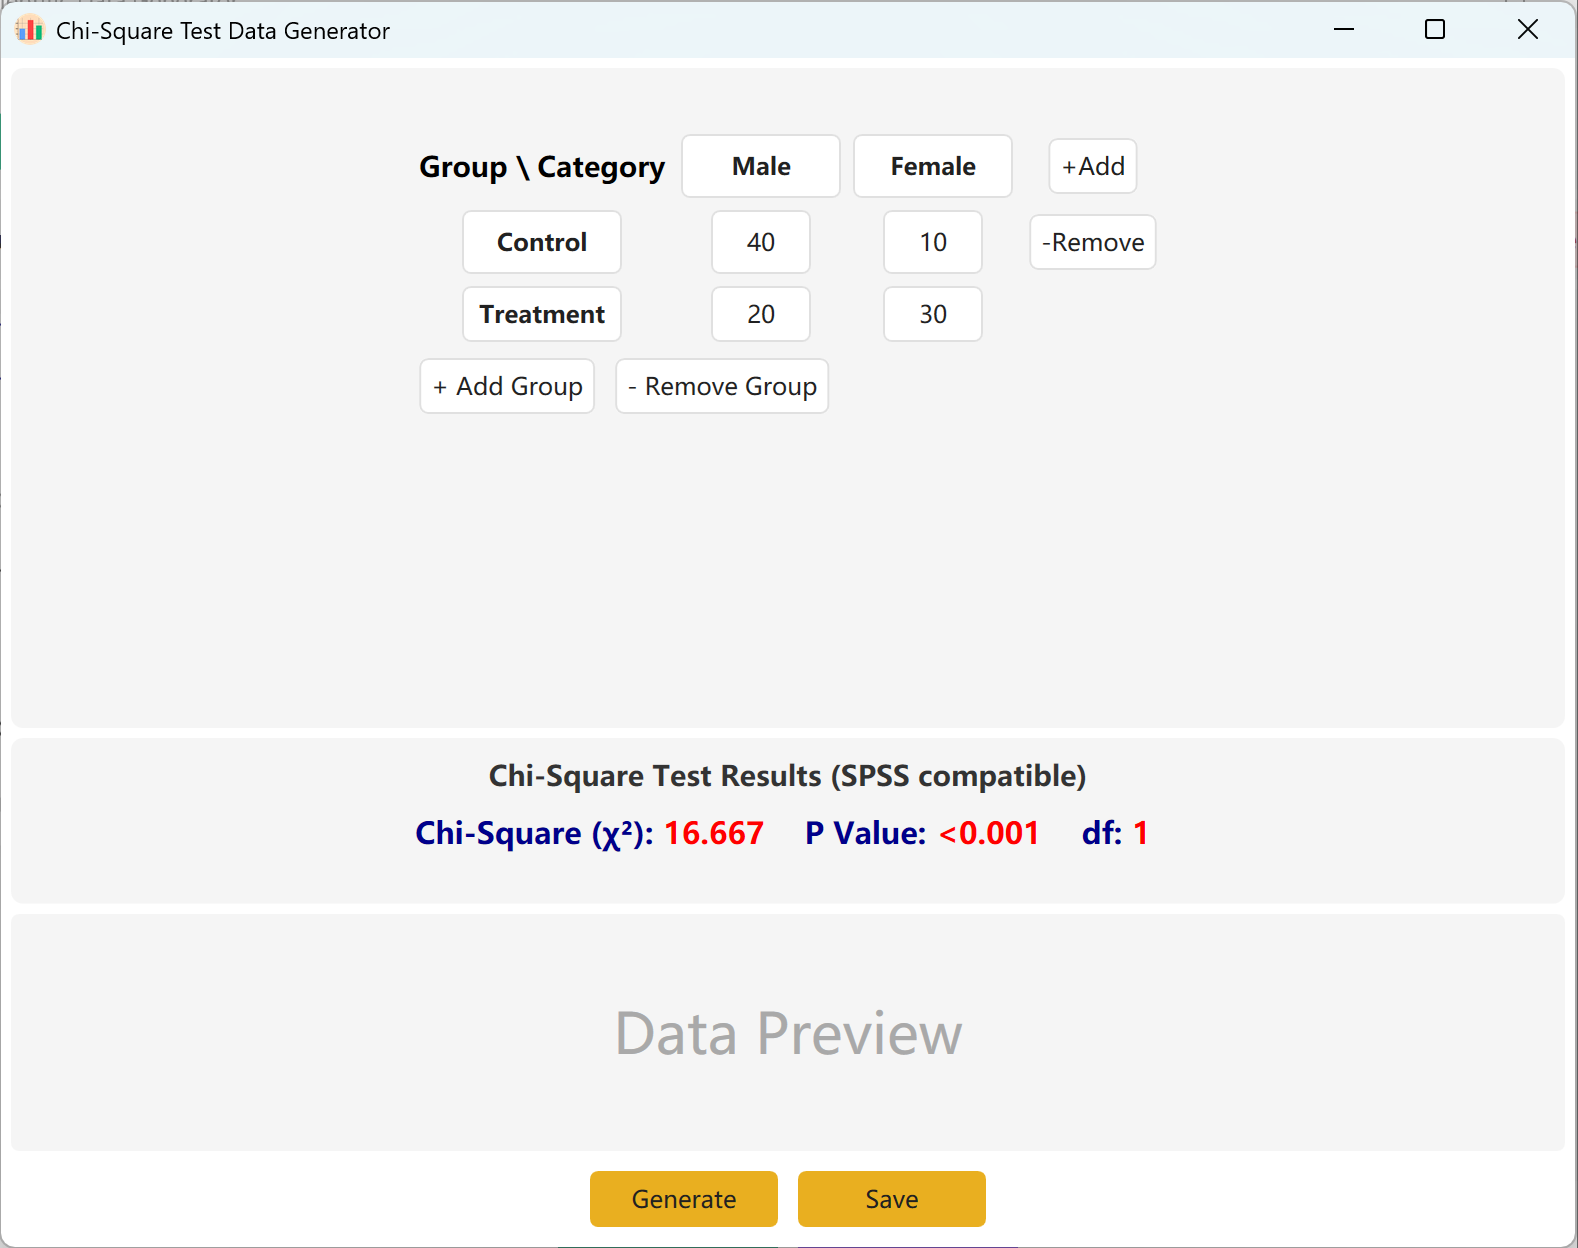
Рисунок 4.1: Настройка критерия Хи-квадрат
4.2 Матрица сопряженности
Интерфейс по умолчанию использует стандартную таблицу сопряженности 2x2. Заполните наблюдаемые частоты для каждой ячейки.
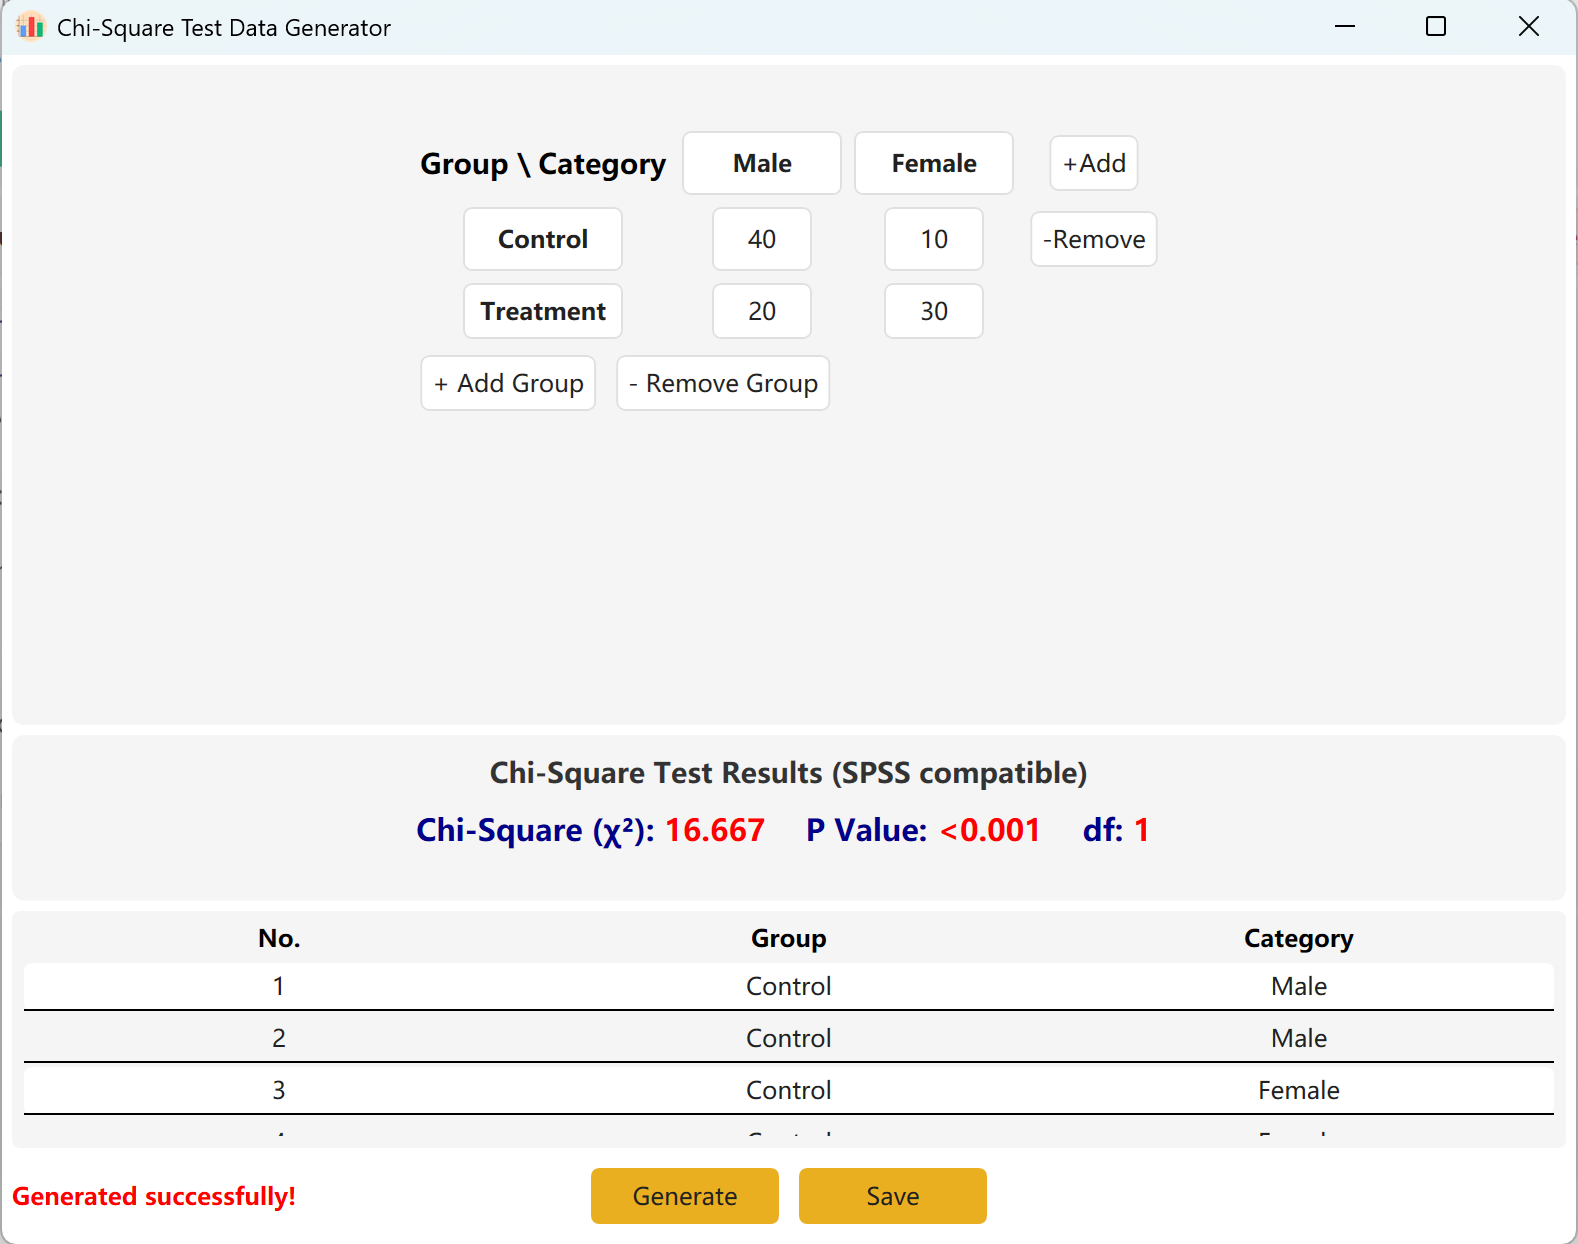
Рисунок 4.2: Отображение данных критерия Хи-квадрат
3. Парный критерий Хи-квадрат (Paired Chi-Square Test)
Предназначен для парных сравнительных исследований и анализа категориальных результатов «до и после».
3.1 Порядок работы
Перейдите в меню Analyze → Paired Chi-Square Test:
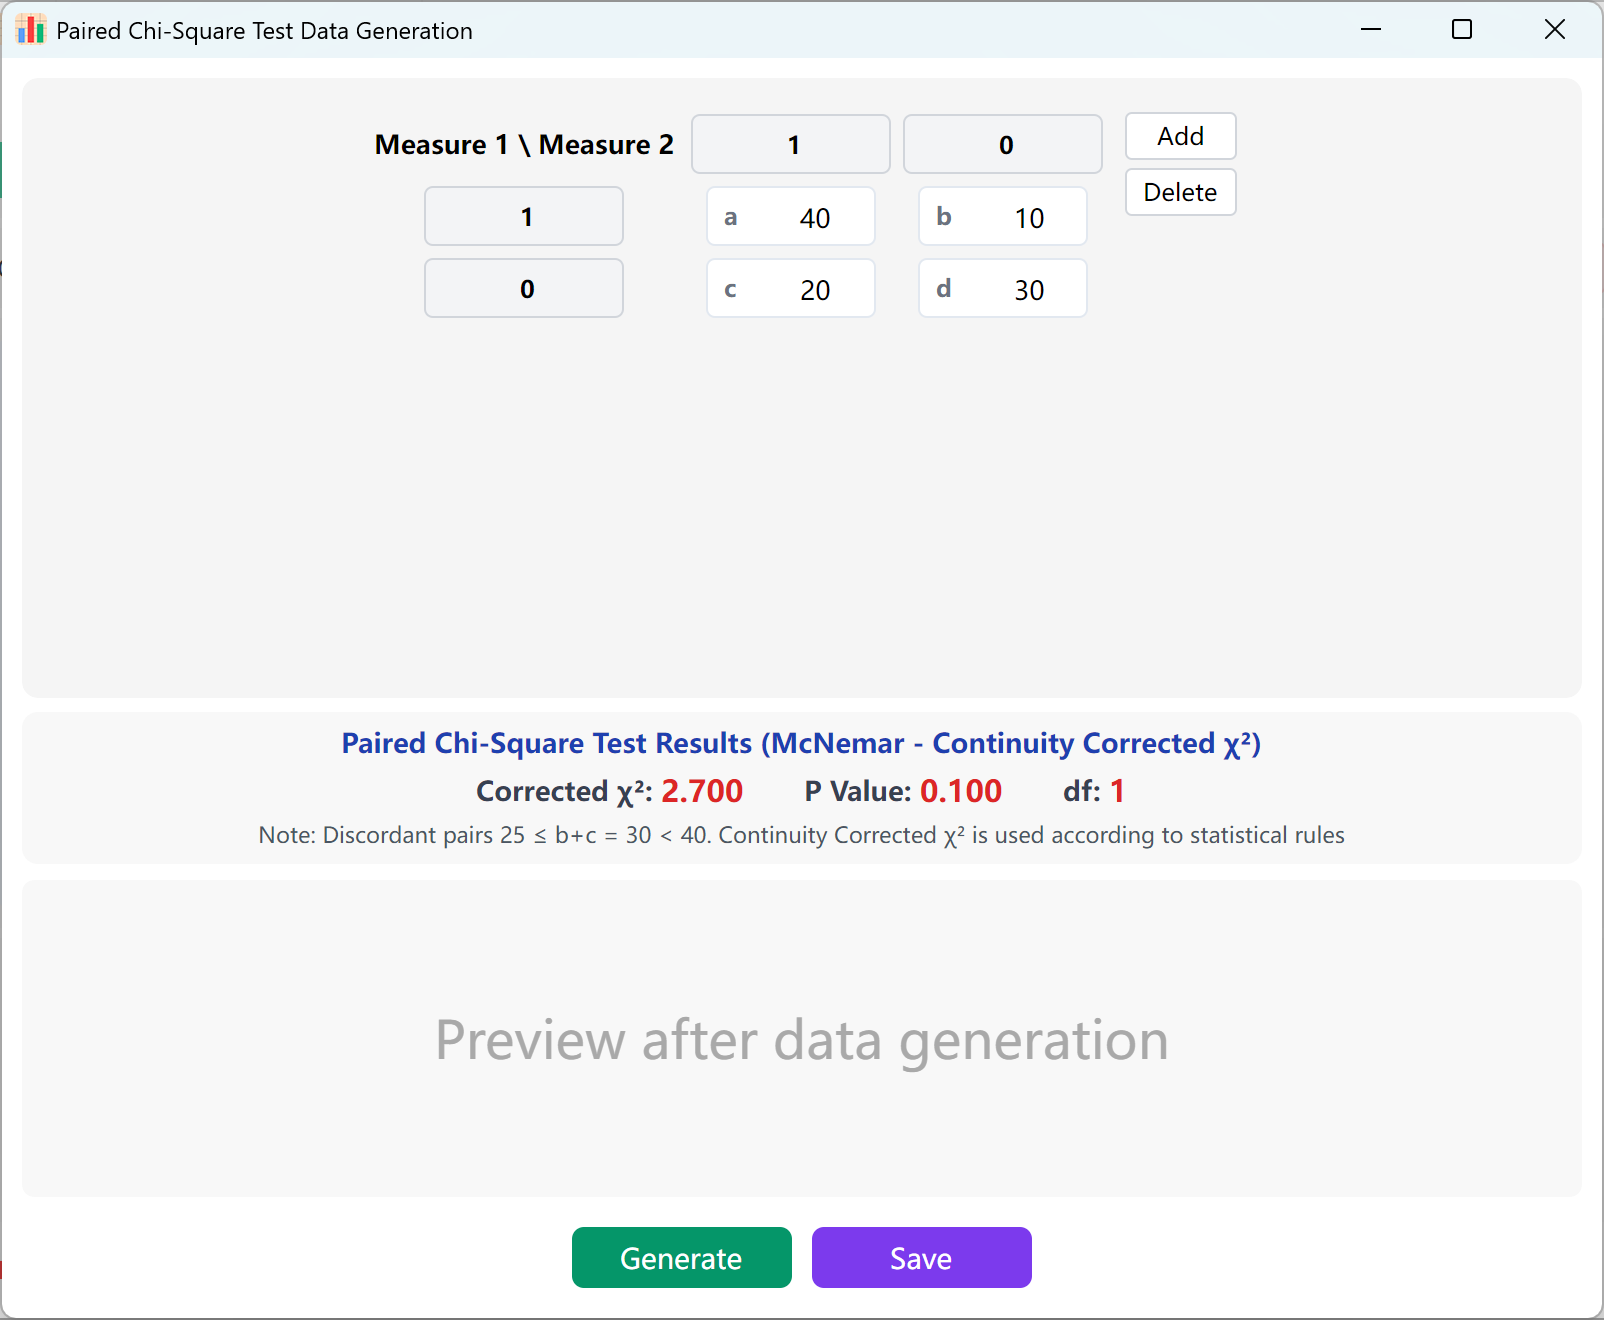
Рисунок 3.1: Настройка параметров парного критерия Хи-квадрат
В четырехпольной таблице 2×2 (критерий Мак-Немара / McNemar's Test) выбор метода определяется числом несовпадающих пар (b + c):
- b + c < 25: Точный биномиальный критерий (Exact Binomial Test).
- 25 ≤ b + c < 40: Критерий Хи-квадрат с поправкой на непрерывность.
- b + c ≥ 40: Асимптотический стандартный критерий Хи-квадрат.
При таблицах 3×3 и выше используется критерий симметрии Мак-Немара — Боукера (полная совместимость с IBM SPSS).
4. Независимый T-Тест
Предназначен для поперечных исследований, сравнивающих средние двух различных групп. Широко используется в клинических испытаниях и социологических опросах.
2.1 Рабочий процесс
Перейдите в Analyze → Independent T-Test.
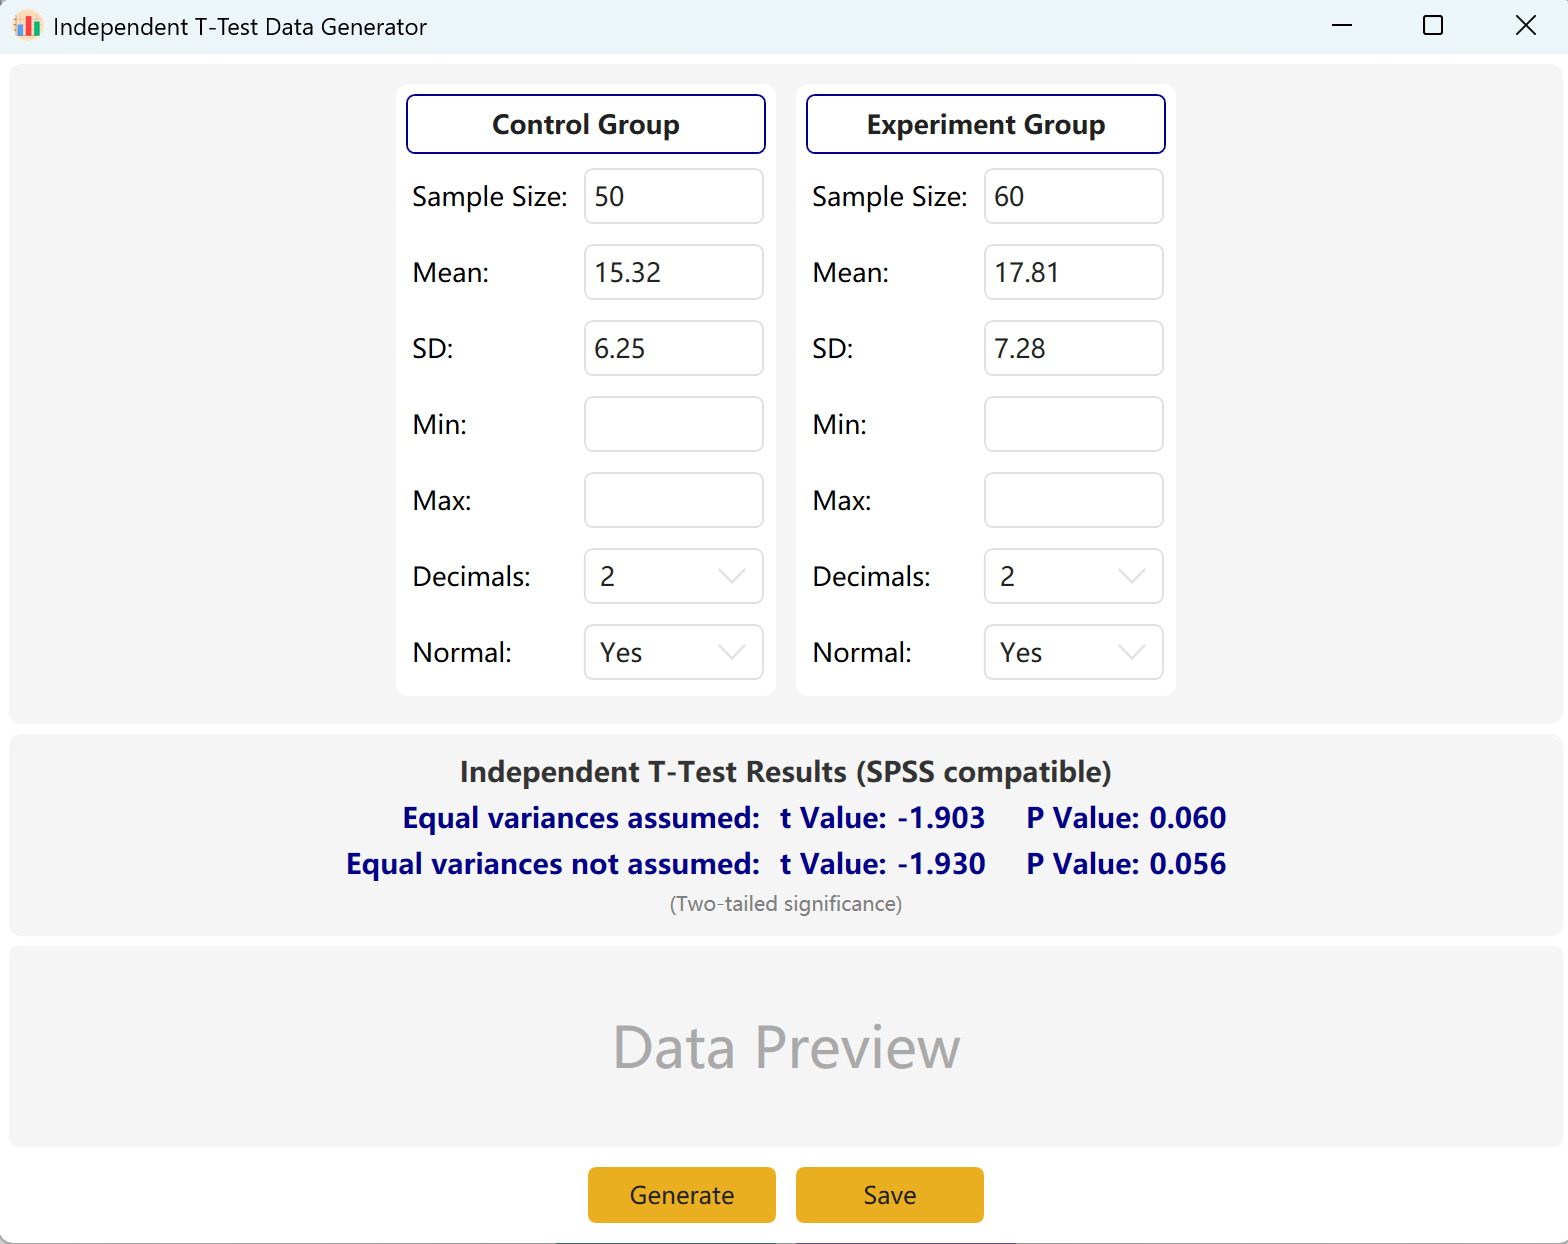
Рисунок 2.1: Настройка независимого T-Теста
2.2 Параметры
Программа предварительно заполняет примеры настроек для «Контрольной группы» и «Экспериментальной группы». Введите размер выборки, среднее и стандартное отклонение для каждой группы, чтобы просмотреть вычисленные t-значение и p-значение в реальном времени.
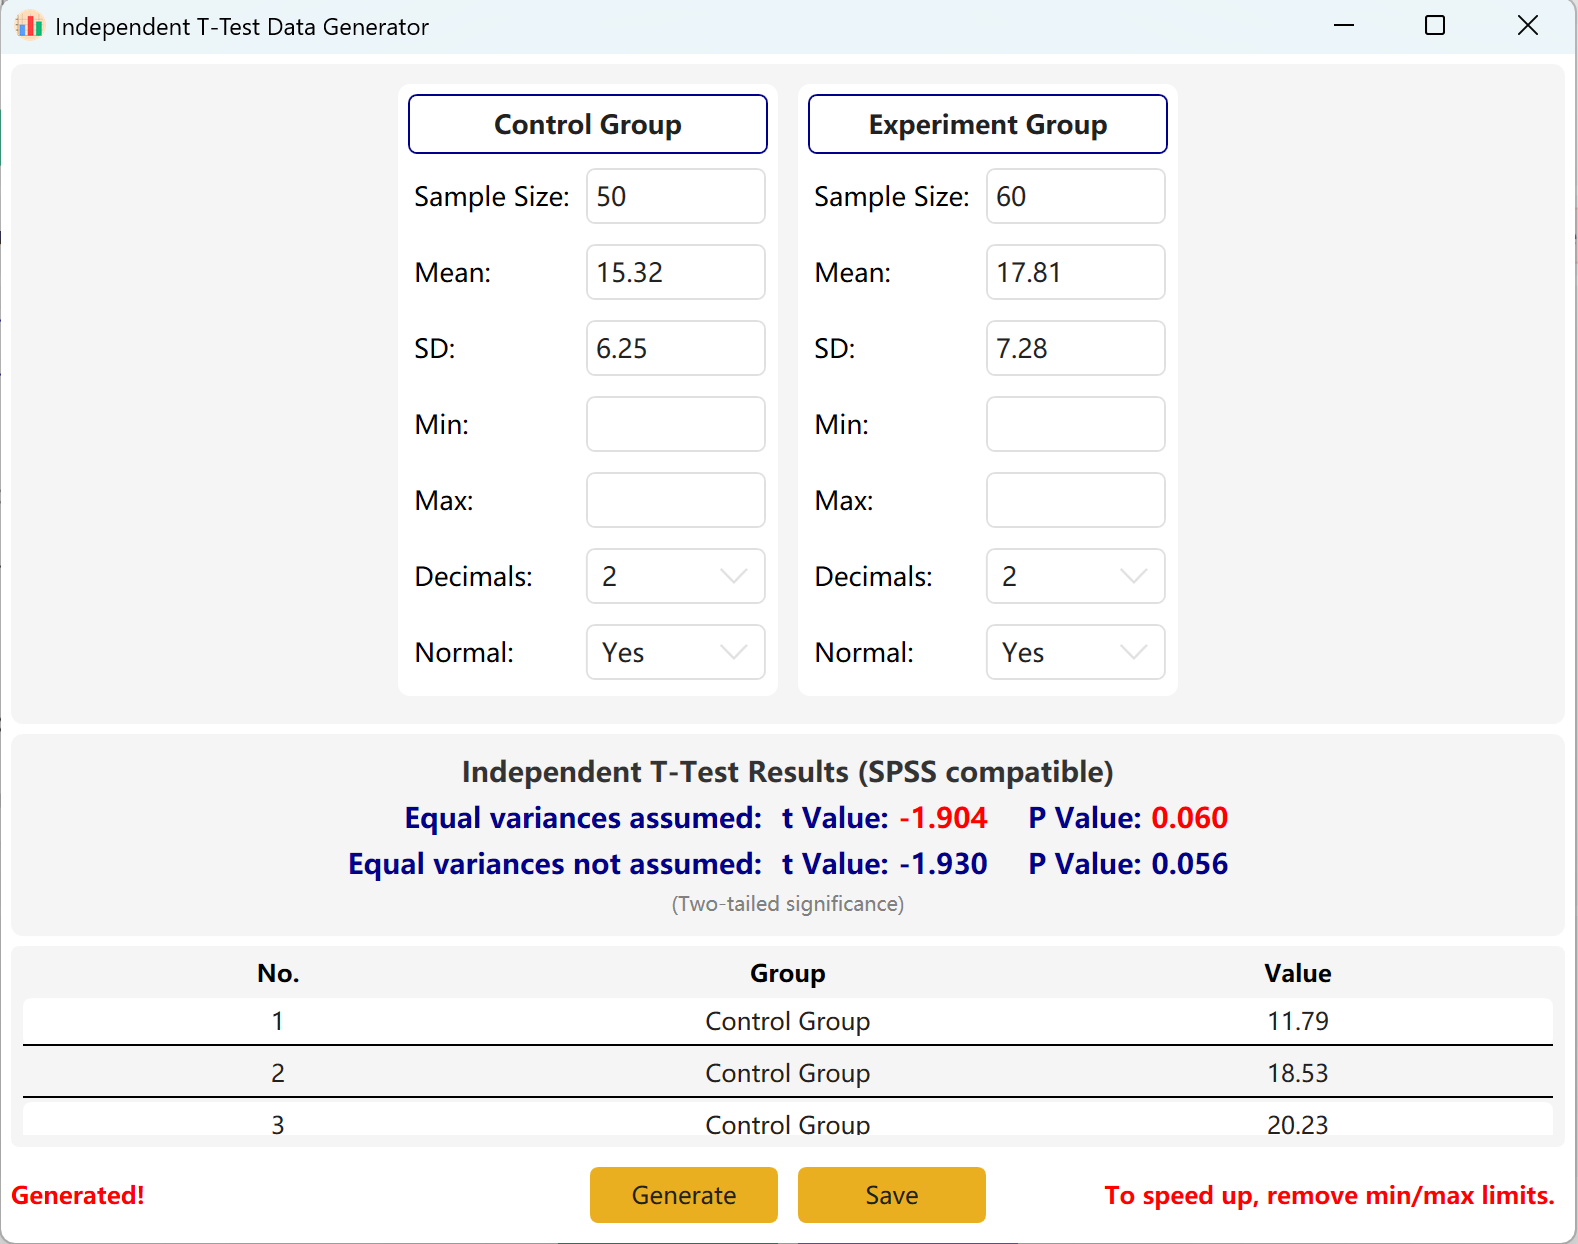
Рисунок 2.2: Отображение данных независимого T-Теста
5. Парный T-Тест
Используется для лонгитюдных исследований или crossover-исследований, где одни и те же субъекты измеряются дважды (например, до и после теста).
3.1 Рабочий процесс
Перейдите в Analyze → Paired T-Test.
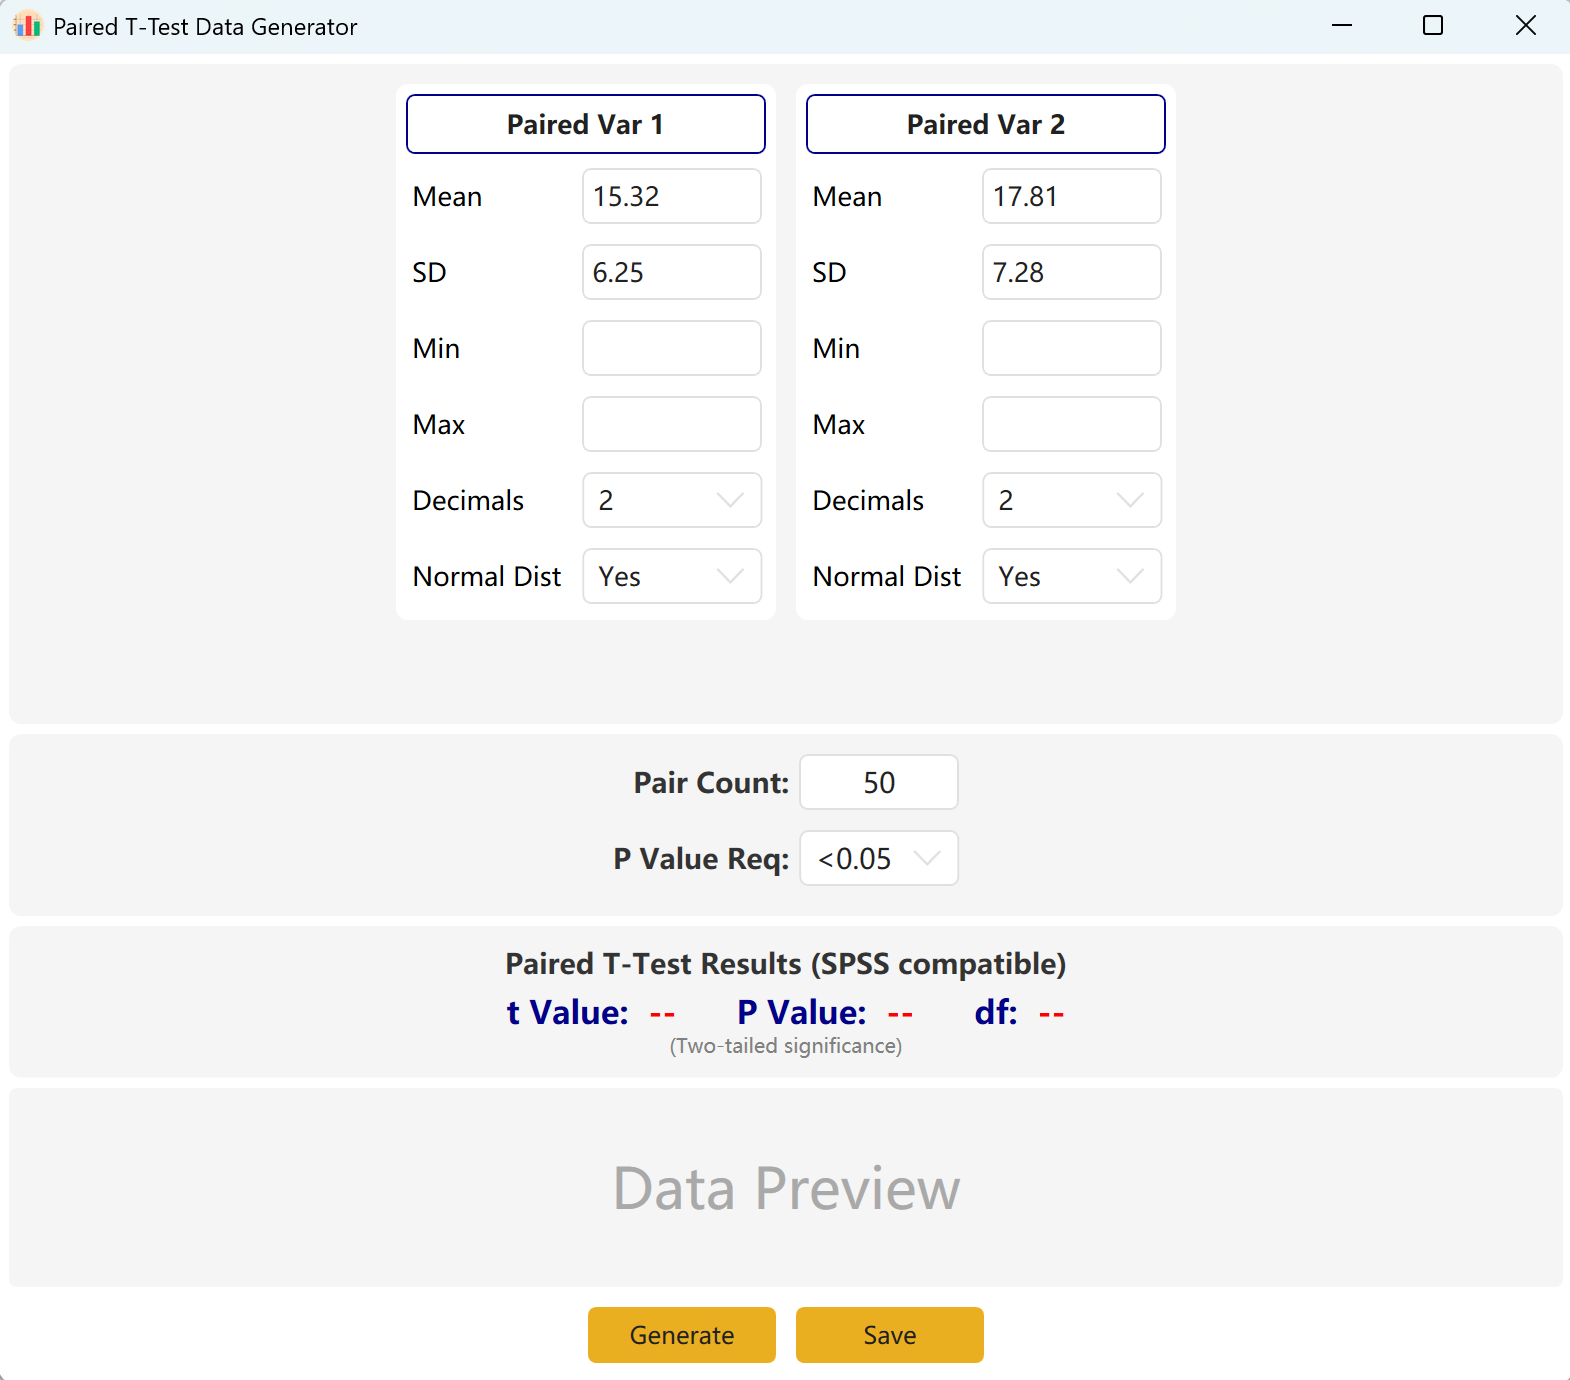
Рисунок 3.1: Настройка парного T-Теста
3.2 Логика моделирования
Программа по умолчанию устанавливает две парные переменные. Вы можете определить среднее и стандартное отклонение для каждой переменной и установить целевой диапазон p-значения.
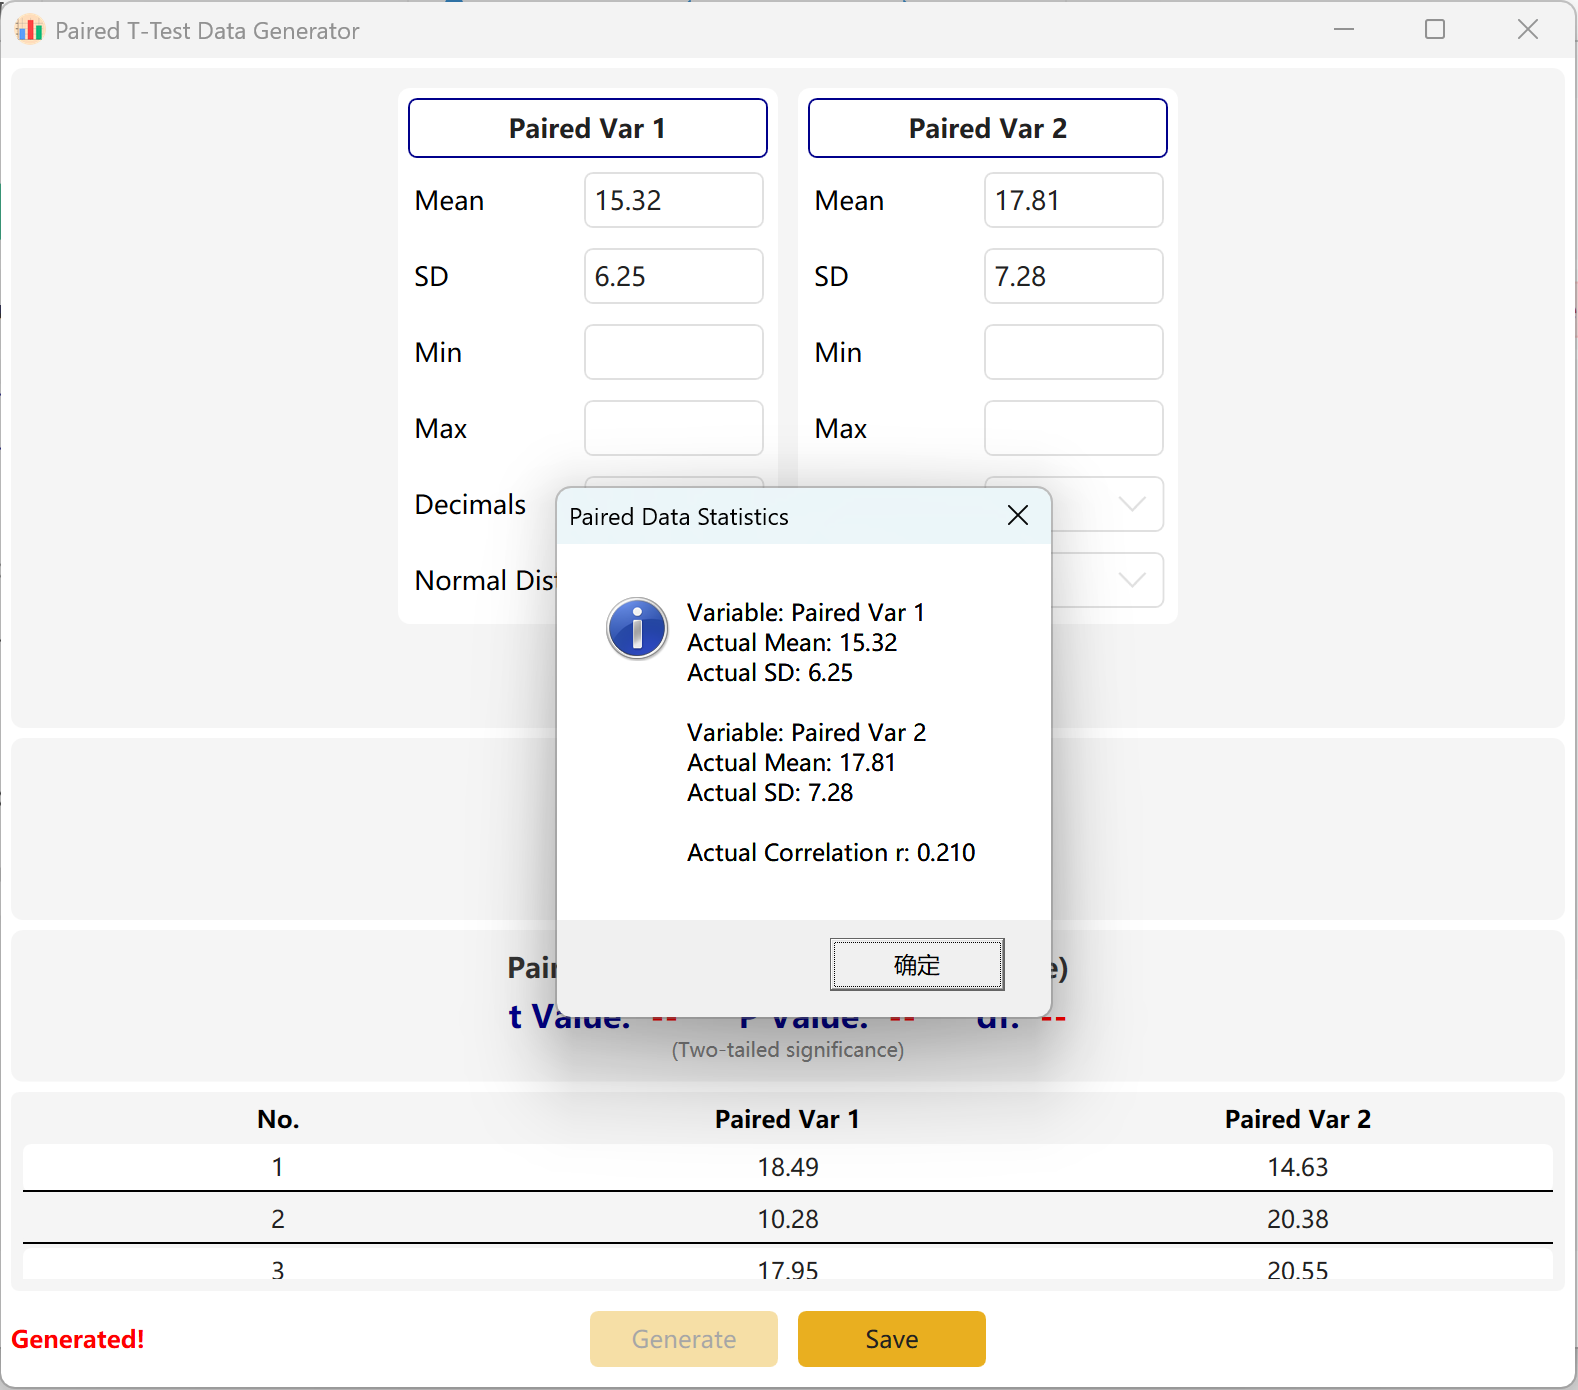
Рисунок 3.2: Отображение данных парного T-Теста
6. Генерация квартильных данных
Разделяет упорядоченный по рангам набор данных на четыре равные части. Полезно для оценки разброса и центральной тенденции данных.
10.1 Рабочий процесс
Перейдите в Analyze → Quartile Data.
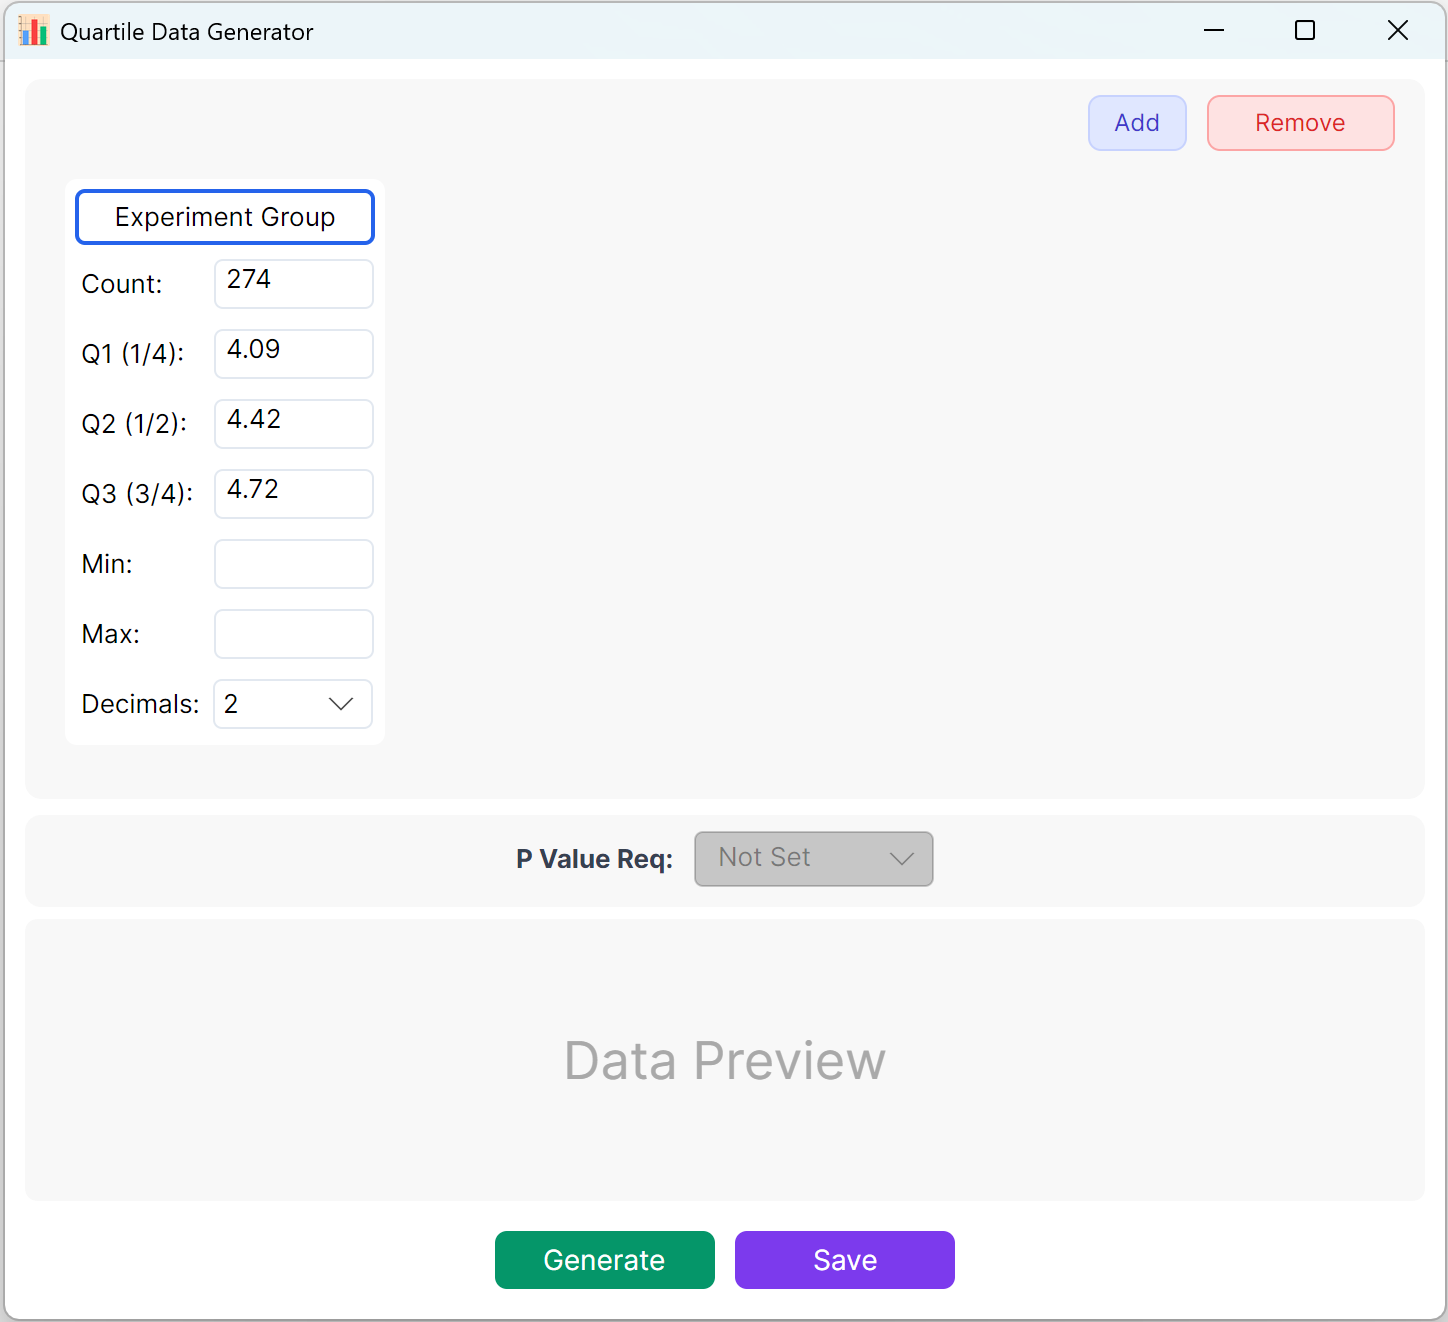
Рисунок 10.1: Настройка квартильных данных
7. Однофакторный ANOVA
Используется при сравнении средних трех или более независимых групп. Алгоритм синтезирует внутригрупповую дисперсию и межгрупповые различия для достижения целевых F-значений.
5.1 Рабочий процесс
Перейдите в Analyze → ANOVA → One-Way ANOVA.
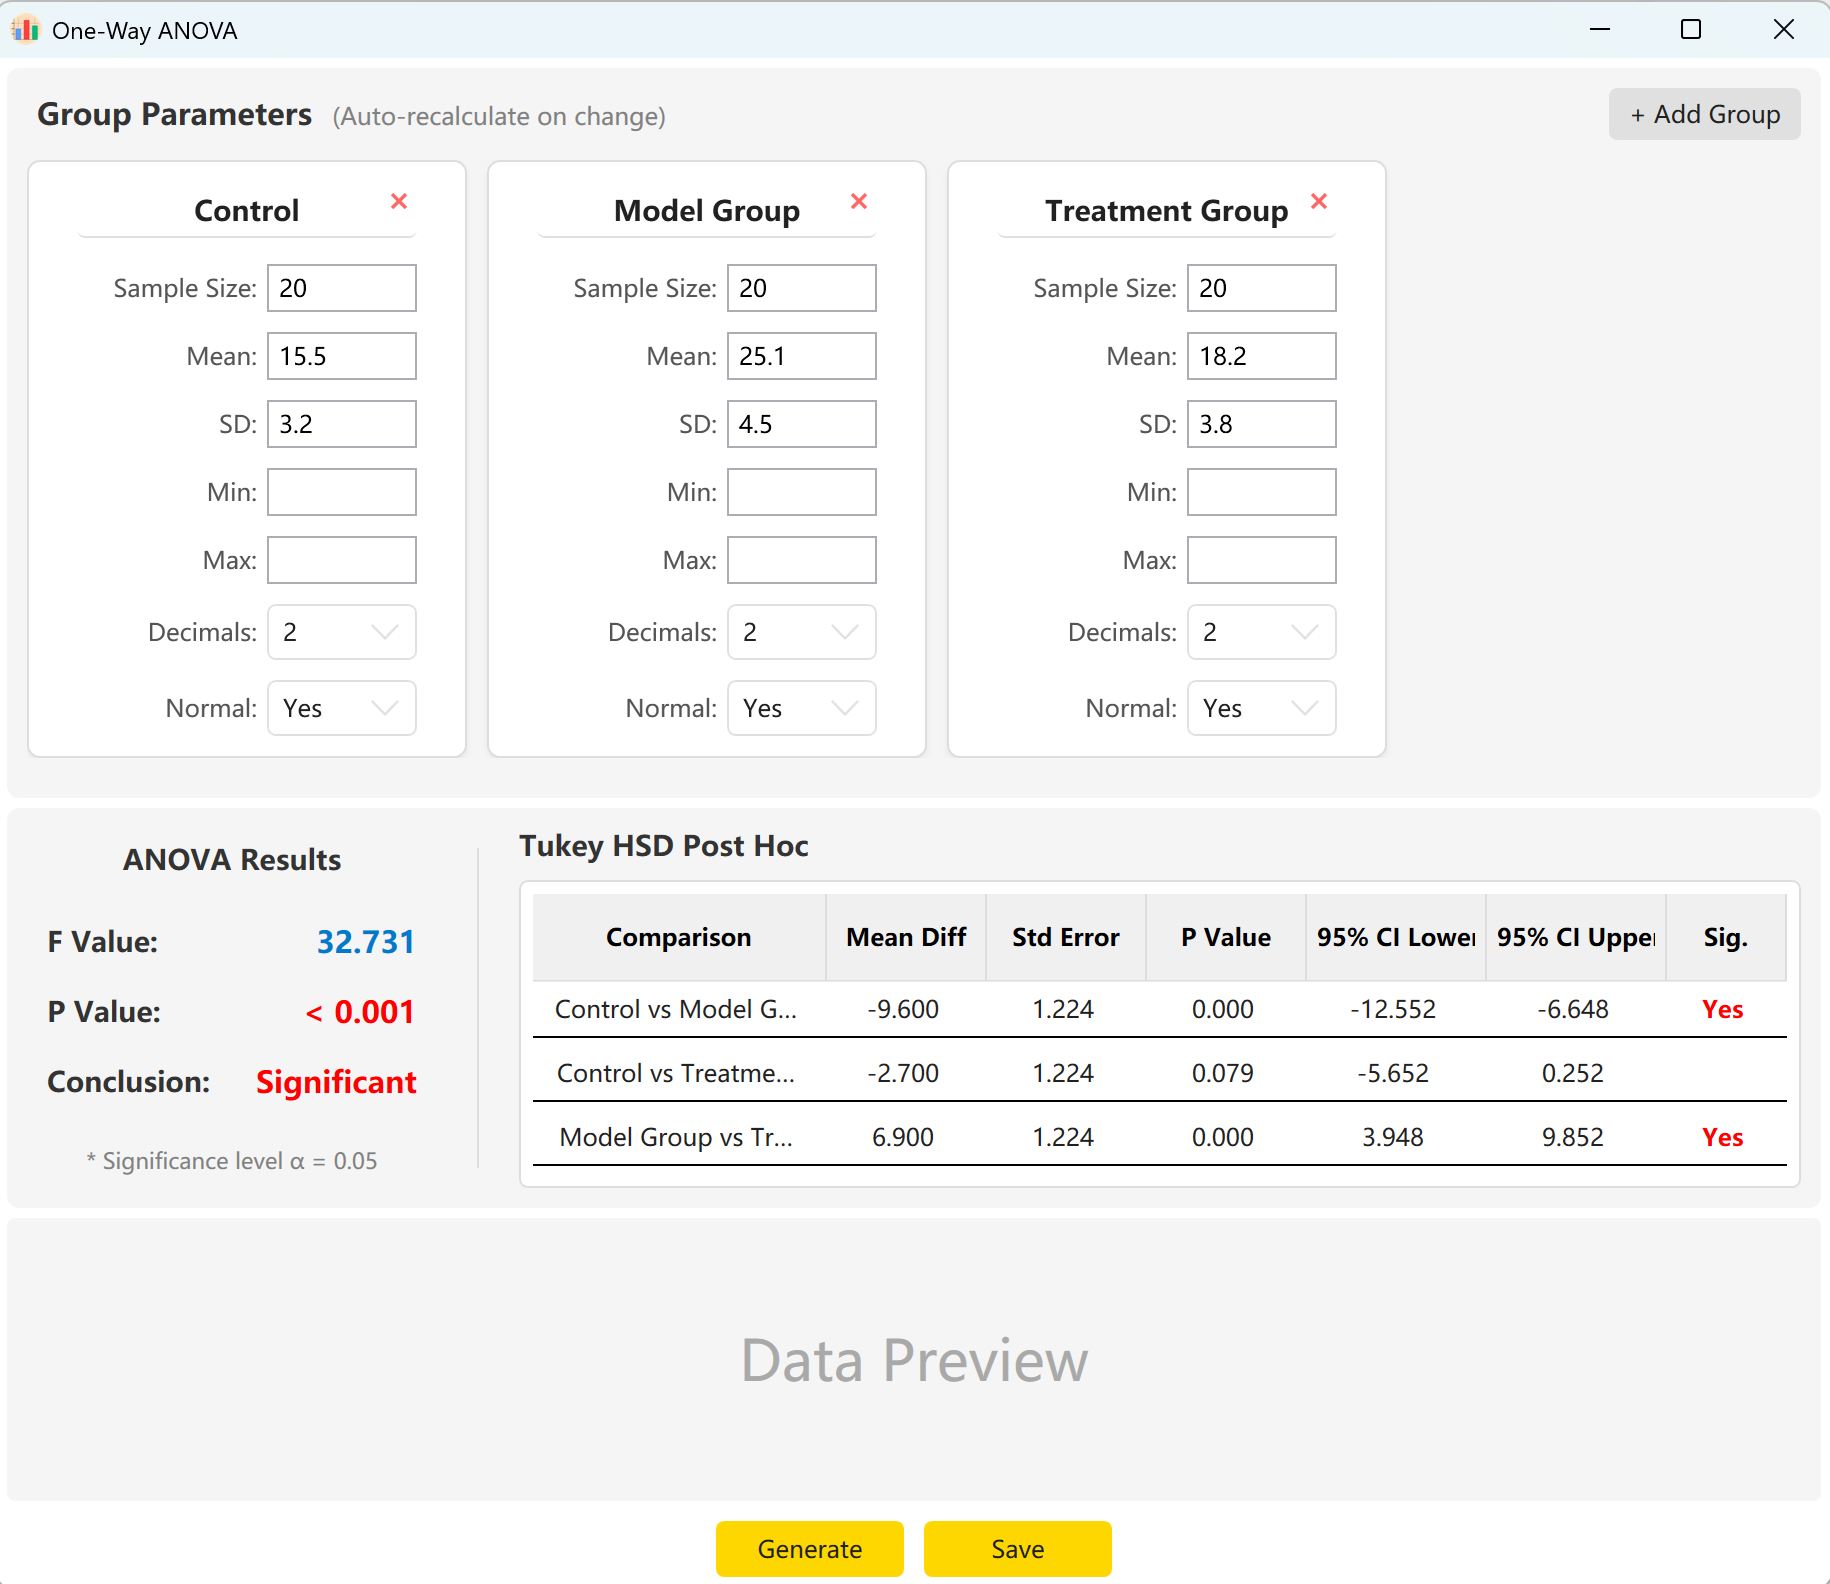
Рисунок 5.1: Настройка однофакторного ANOVA
5.2 Конфигурация
Система предварительно загружает параметры для трех групп. Просто введите размер выборки, среднее и стандартное отклонение для каждой группы.
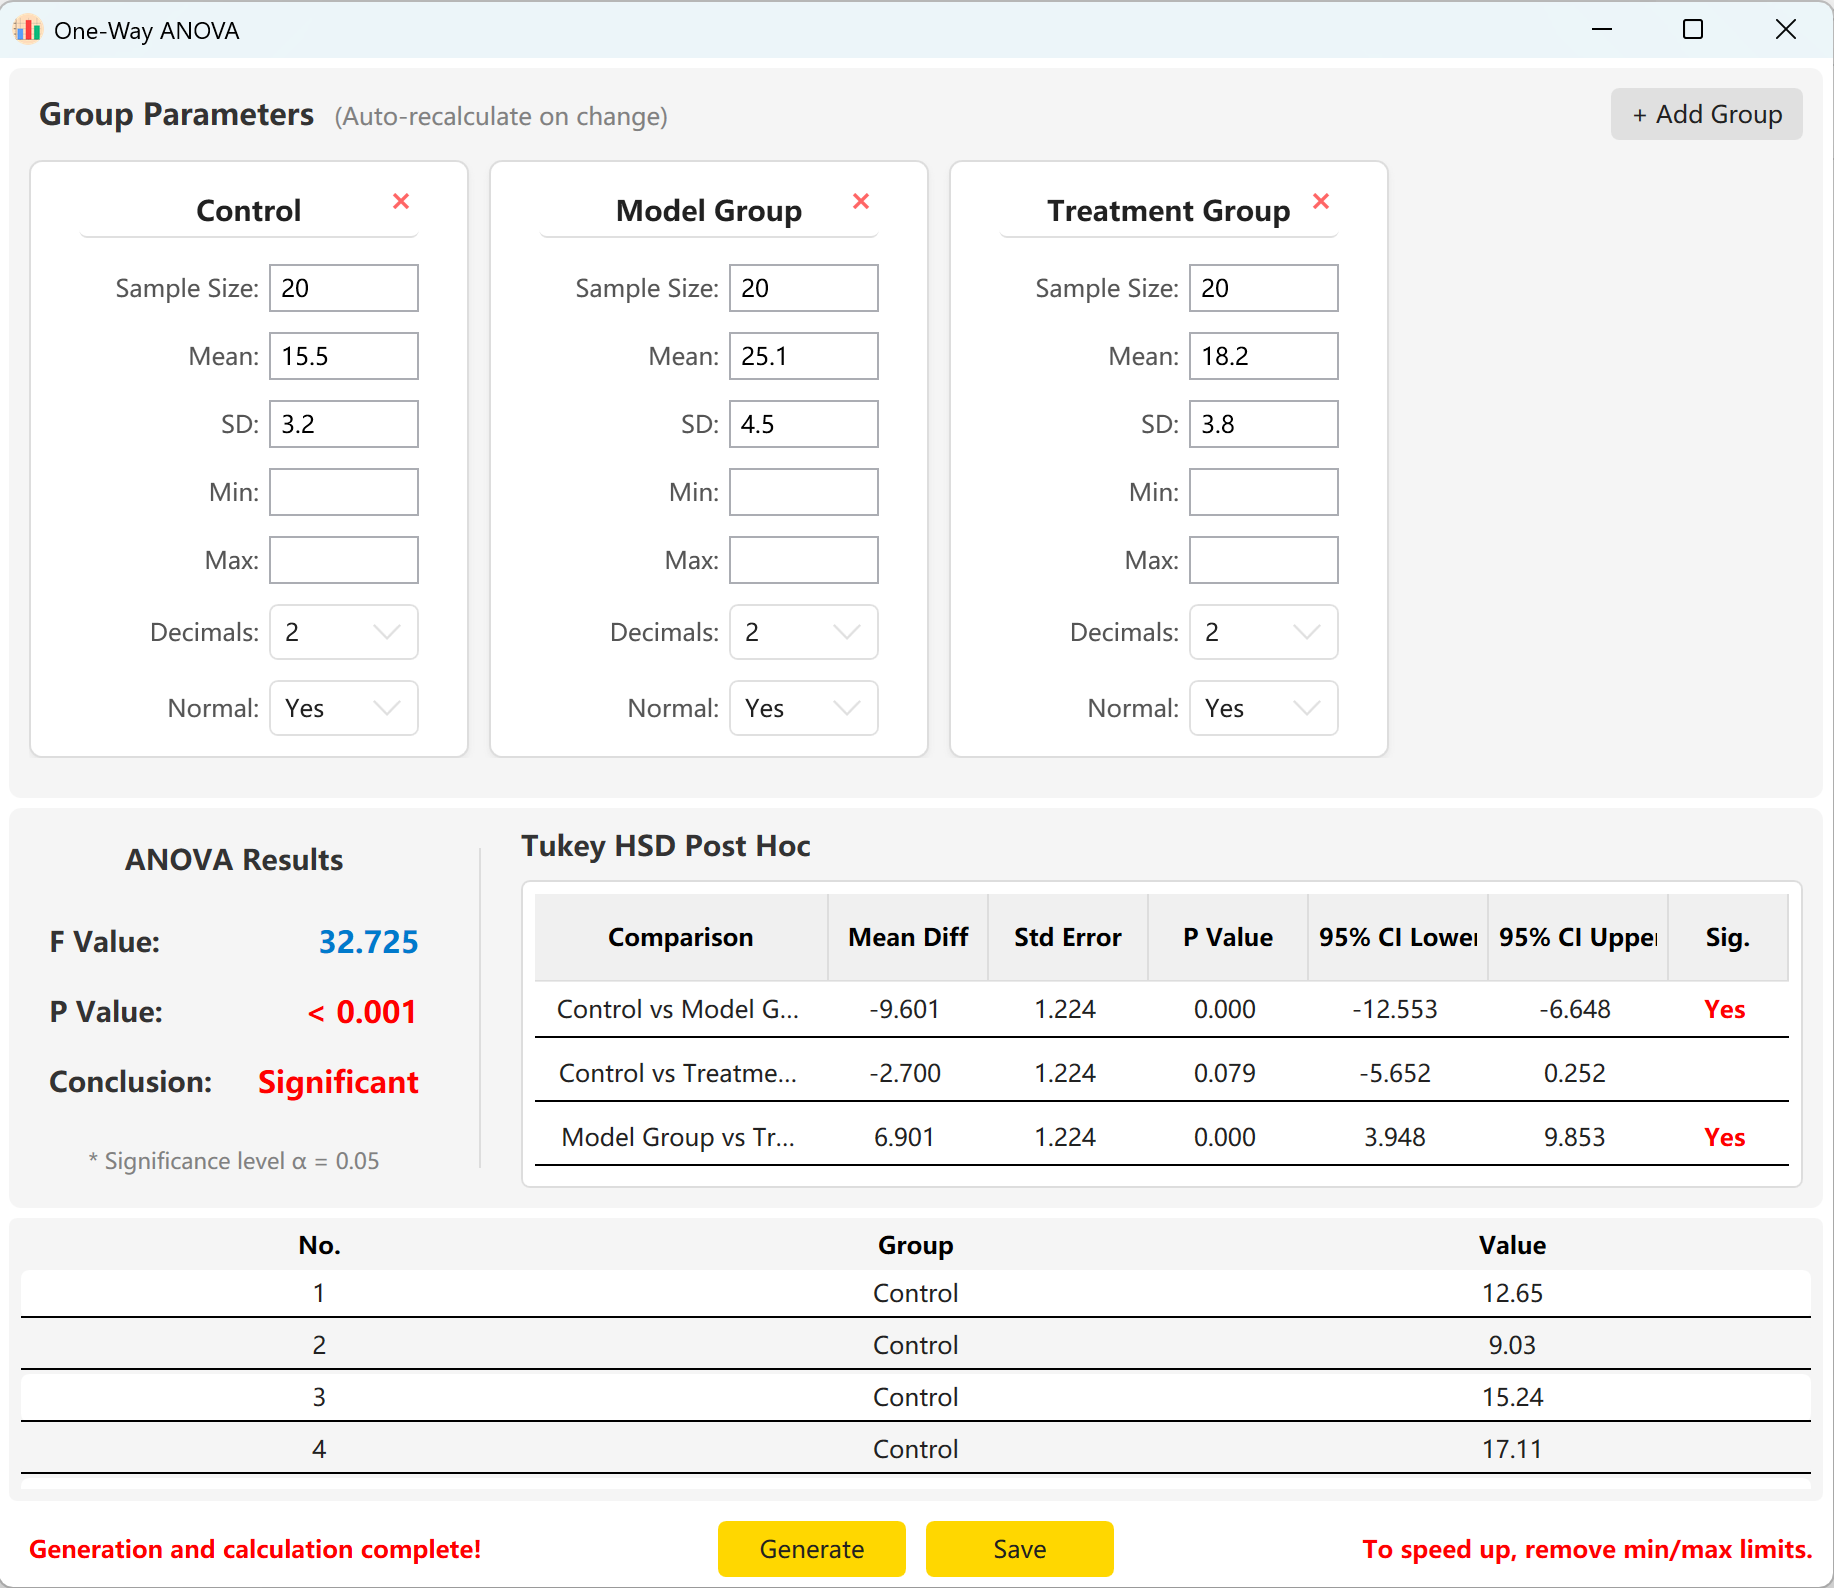
Рисунок 5.2: Отображение данных однофакторного ANOVA
8. Двухфакторный ANOVA
Исследует влияние двух независимых категориальных переменных на одну непрерывную зависимую переменную.
6.1 Рабочий процесс
Перейдите в Analyze → ANOVA → Two-Way ANOVA.
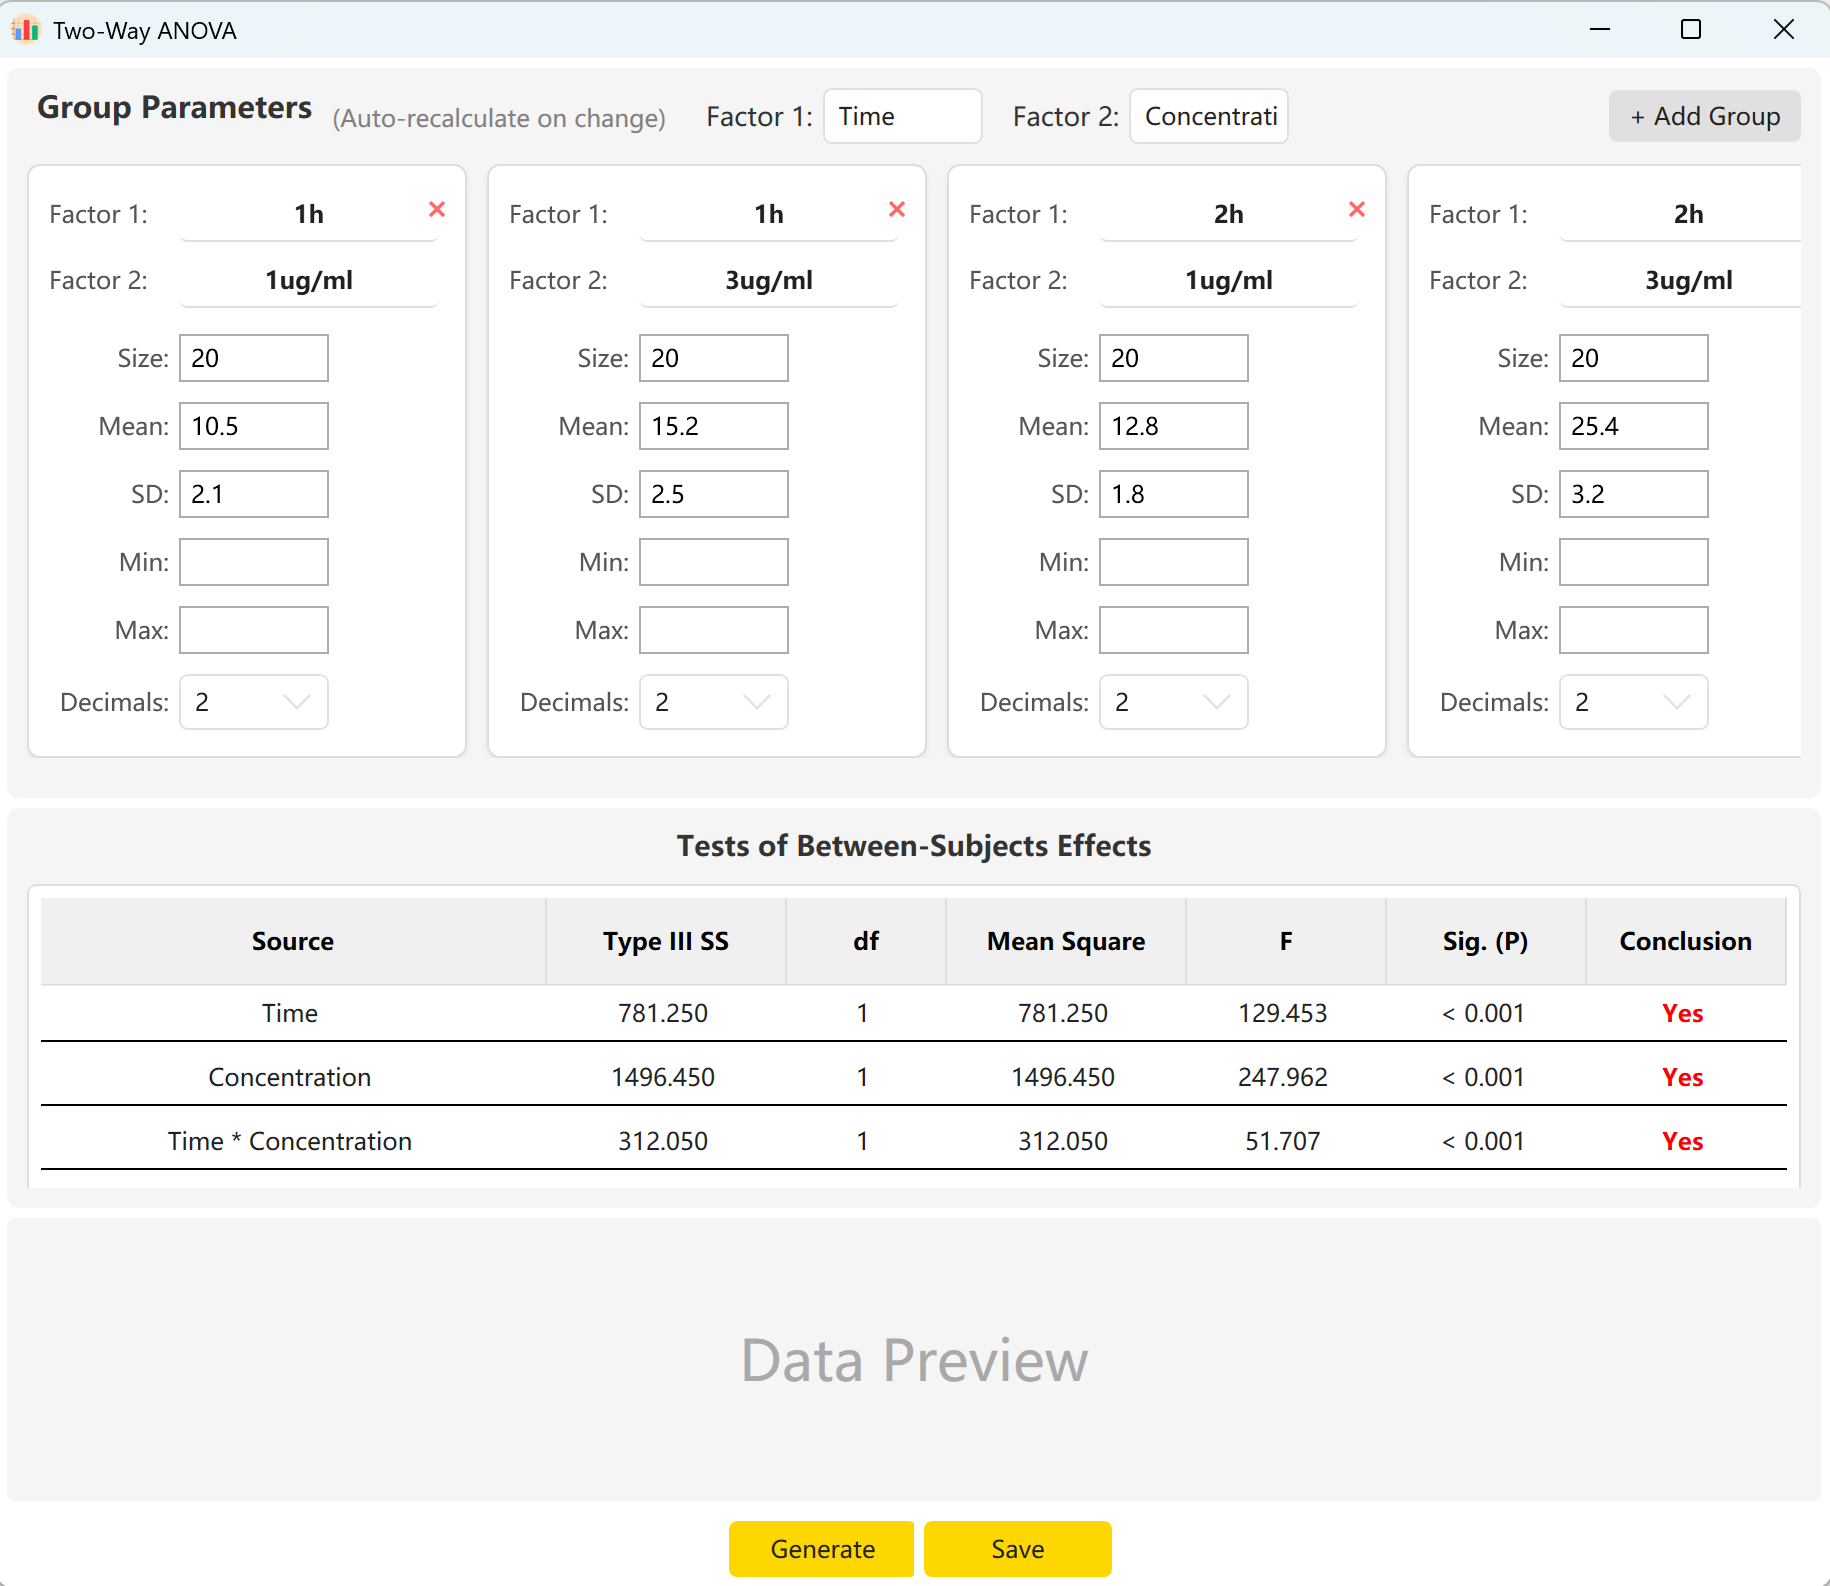
Рисунок 6.1: Настройка двухфакторного ANOVA
6.2 Факторы и взаимодействия
Инструмент по умолчанию использует два фактора: «Время» и «Концентрация».
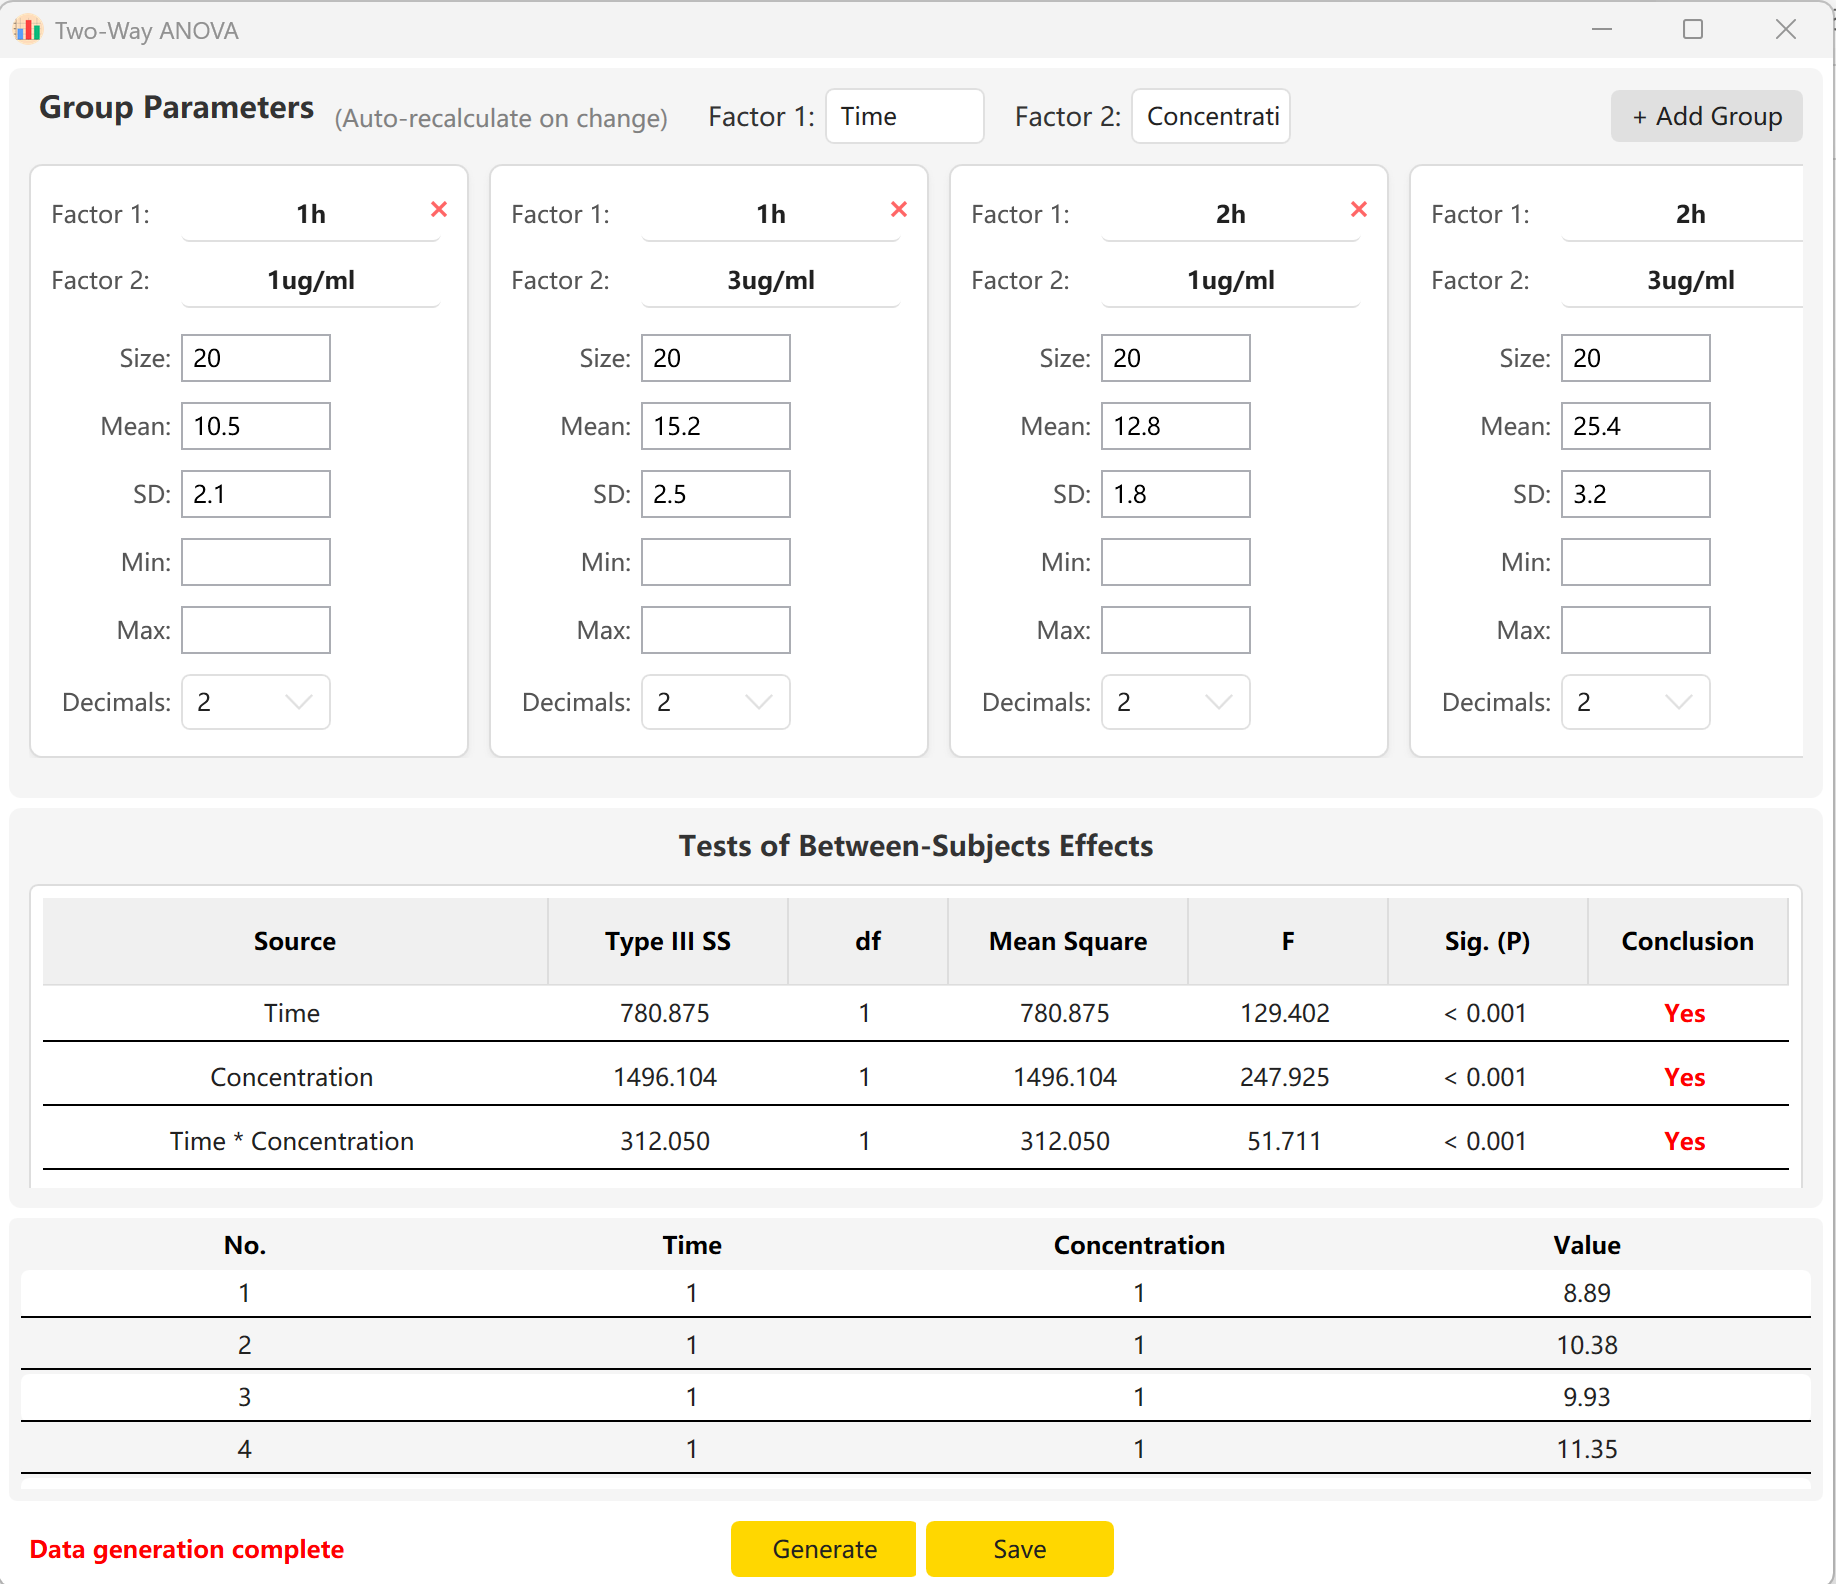
Рисунок 6.2: Отображение данных двухфакторного ANOVA
9. Однофакторный ANOVA с повторными измерениями
Расширение парного T-Теста на три или более временных точки. Идеально подходит для лонгитюдного отслеживания.
7.1 Рабочий процесс
Перейдите в Analyze → ANOVA → Repeated Measures ANOVA.
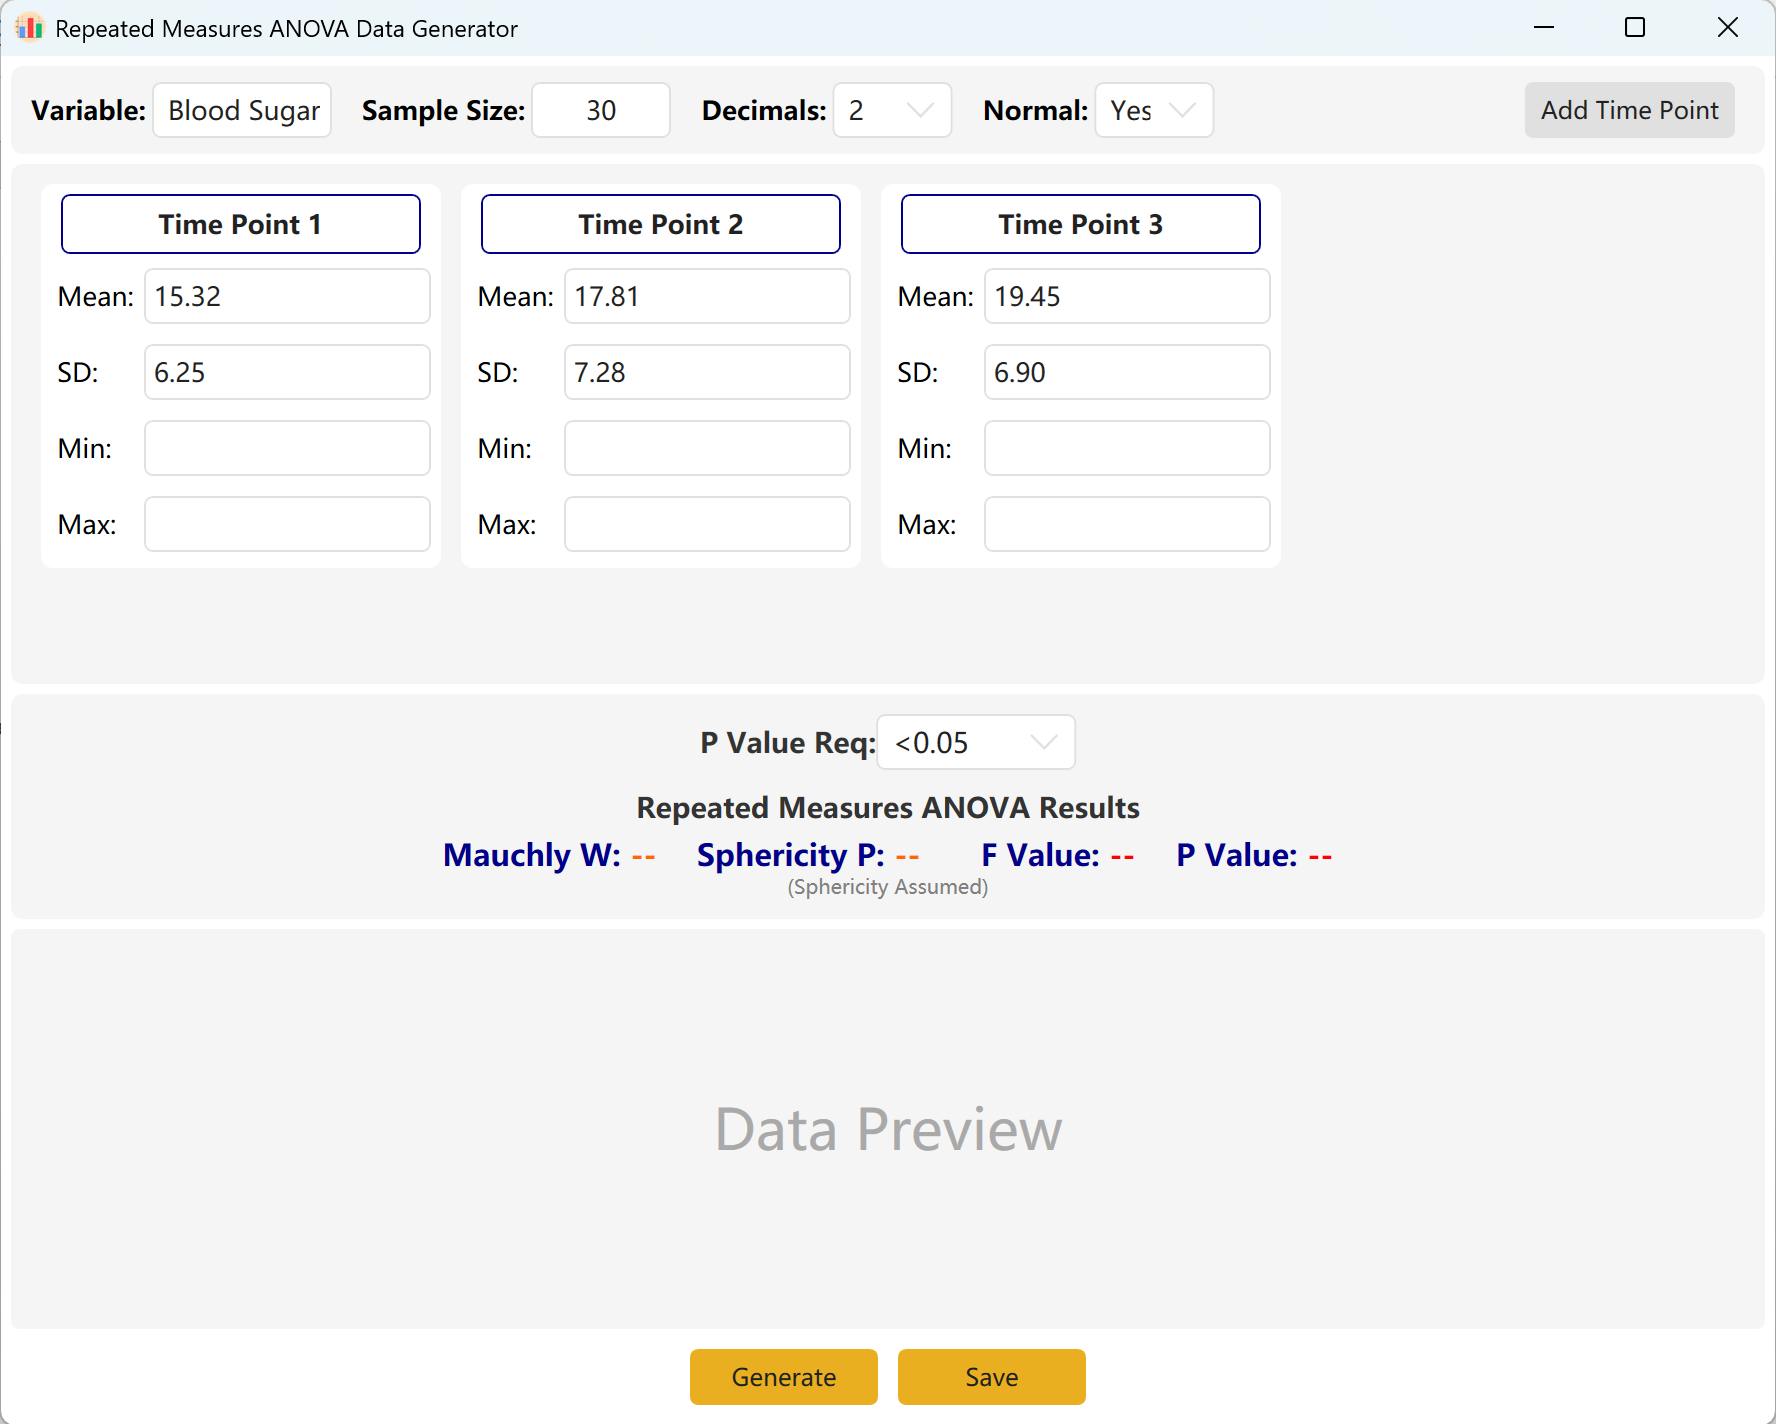
Рисунок 7.1: Настройка ANOVA с повторными измерениями
7.2 Повторные наблюдения
Система по умолчанию использует три временные точки наблюдения.
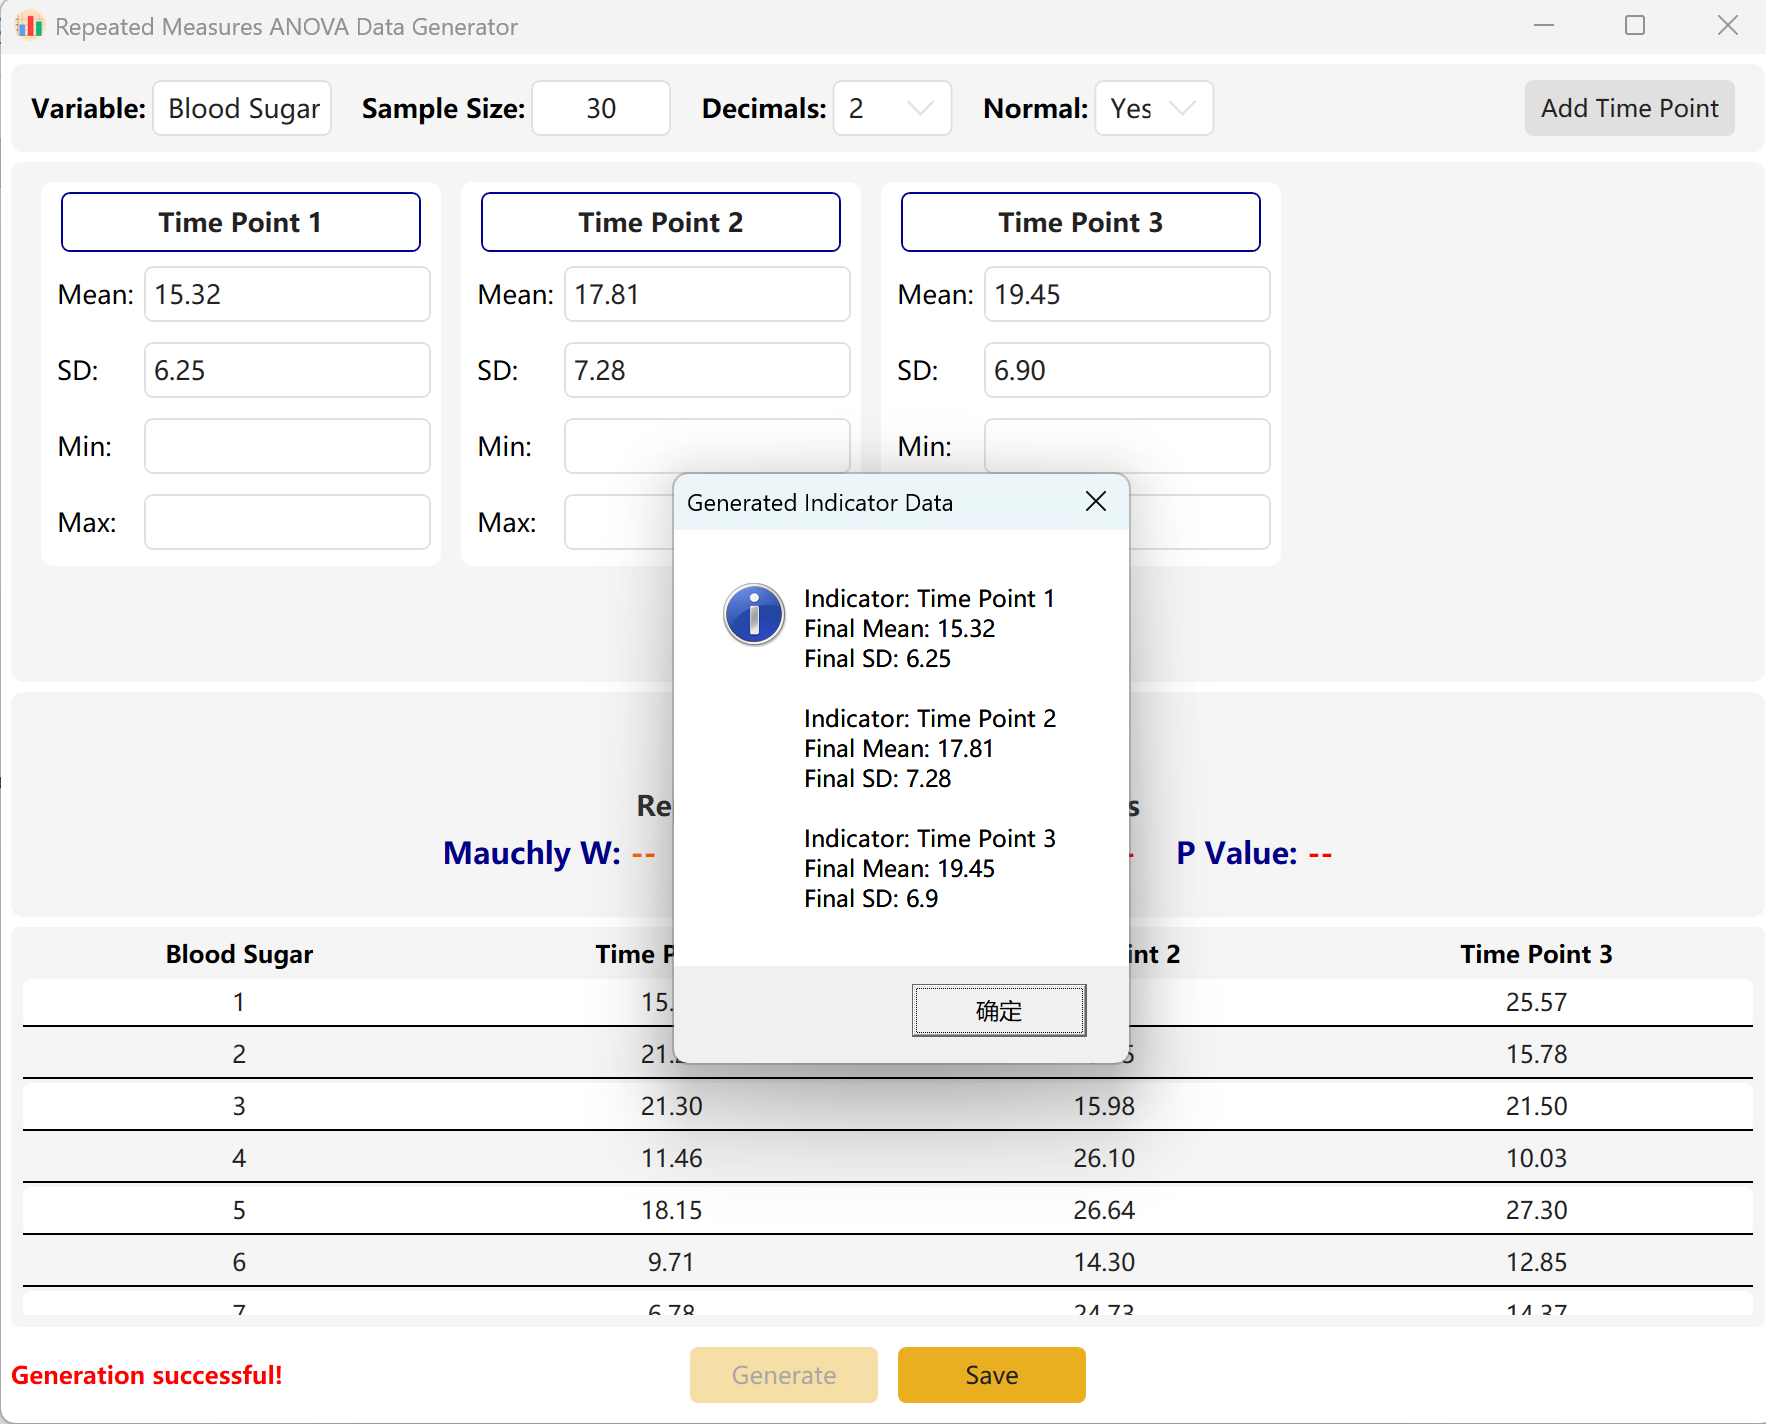
Рисунок 7.2: Отображение данных ANOVA с повторными измерениями
10. Двухфакторный ANOVA с повторными измерениями
Для экспериментов с двумя факторами (например, концентрация и время) и повторными наблюдениями.
10.1 Порядок работы
Перейдите в меню Analyze → ANOVA → Two-Way Repeated Measures ANOVA:
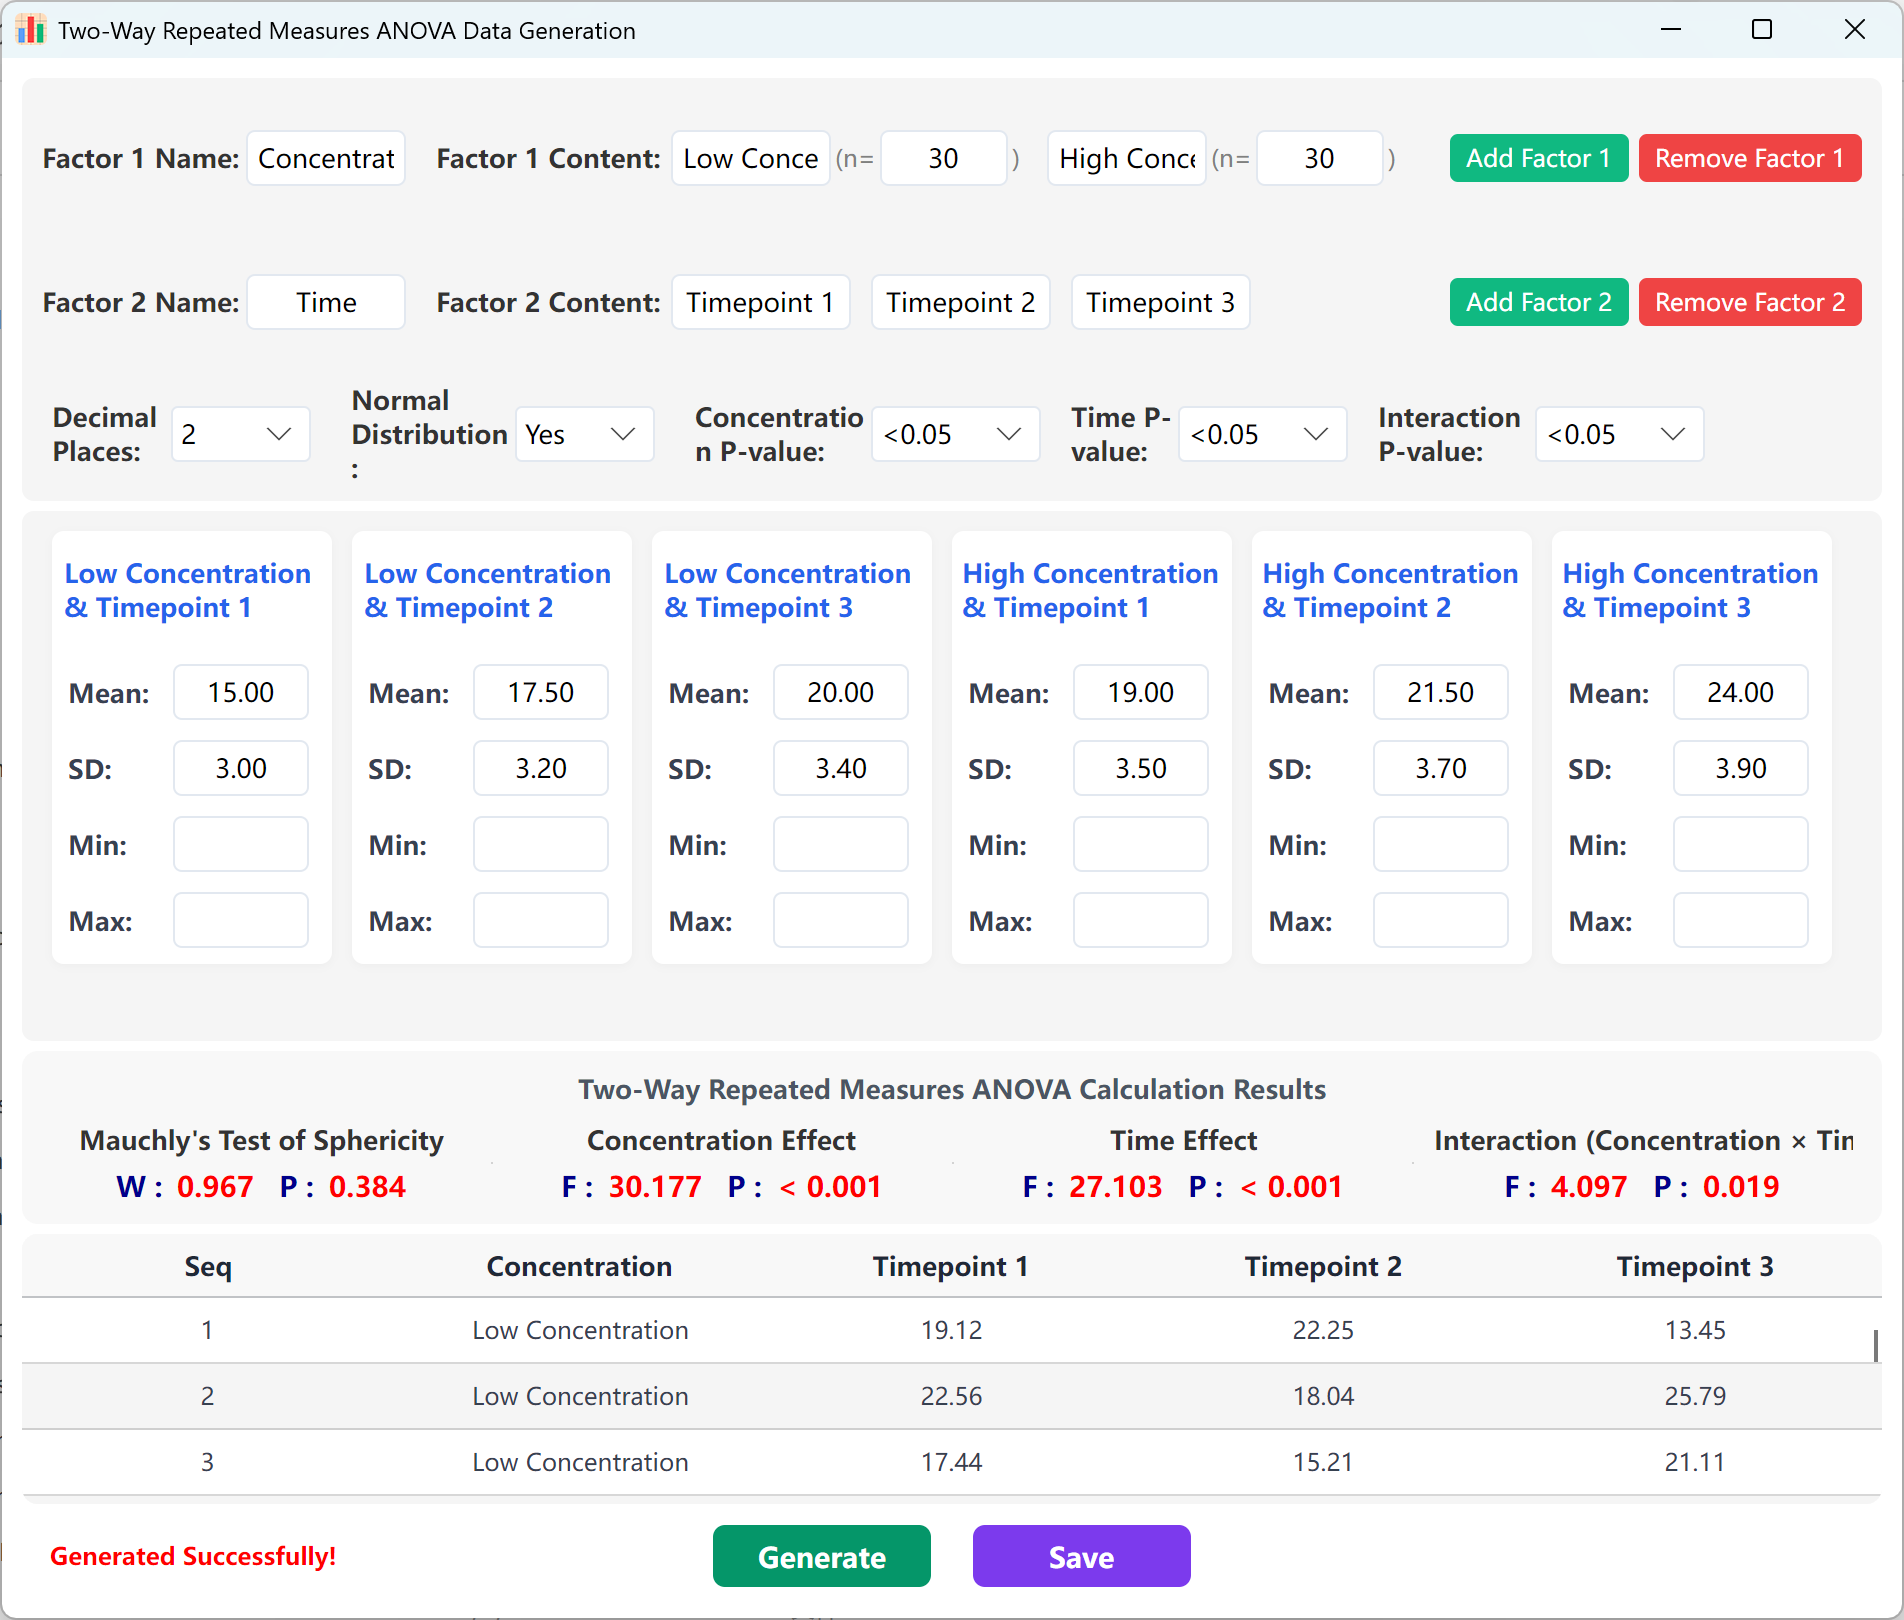
Рисунок 10.1: Настройка двухфакторного дисперсионного анализа с повторными измерениями
10.2 Настройка параметров
По умолчанию заданы концентрация и время (3 временные точки с возможностью добавления). Настройте диапазоны p-value для главных эффектов и взаимодействия, а также средние и стандартные отклонения.
Нажмите Generate Data для генерации синтетического набора данных.
11. Ранговый суммарный тест для двух независимых выборок (Непараметрический)
Альтернатива U-тесту Манна-Уитни для данных, не соответствующих предположению о нормальности.
8.1 Рабочий процесс
Перейдите в Analyze → Non-parametric → 2 Independent Samples.
1.png)
Рисунок 8.1: Настройка теста для двух независимых выборок
12. Критерий Краскела-Уоллиса (K независимых выборок)
Эквивалент H-теста Краскела-Уоллиса. Генерирует порядковые или ненормально распределенные непрерывные данные для трех или более независимых групп.
9.1 Рабочий процесс
Перейдите в Analyze → Non-parametric → K Independent Samples.
1.png)
Рисунок 9.1: Настройка критерия Краскела-Уоллиса
13. Критерий для двух связанных выборок (Непараметрический)
Для сравнения «до и после» в одной группе при ненормальном распределении разностей (критерий знаковых рангов Вилкоксона).
13.1 Порядок работы
Перейдите в меню Analyze → Non-parametric → 2 Related Samples:
 Data Generation.png)
Рисунок 13.1: Настройка критерия для двух связанных выборок
Задайте целевой диапазон p-value и сгенерируйте парные выборки с проверкой по критерию Вилкоксона.
14. Критерий для K связанных выборок (Непараметрический)
Для анализа трех и более связанных условий при отклонении от нормального распределения.
14.1 Порядок работы
Перейдите в меню Analyze → Non-parametric → K Related Samples:
 Data Generation.png)
Рисунок 14.1: Настройка критерия для K связанных выборок
Поддерживает критерий Фридмана (количественные/порядковые данные), W Кендалла (коэффициент конкордации) и Q-критерий Кохрана (бинарные данные).
15. Генерация данных для бинарной логистической регрессии
Необходим для задач классификации, где результат является дихотомическим. Широко используется в эпидемиологии.
11.1 Рабочий процесс
Перейдите в Analyze → Regression → Binary Logistic.
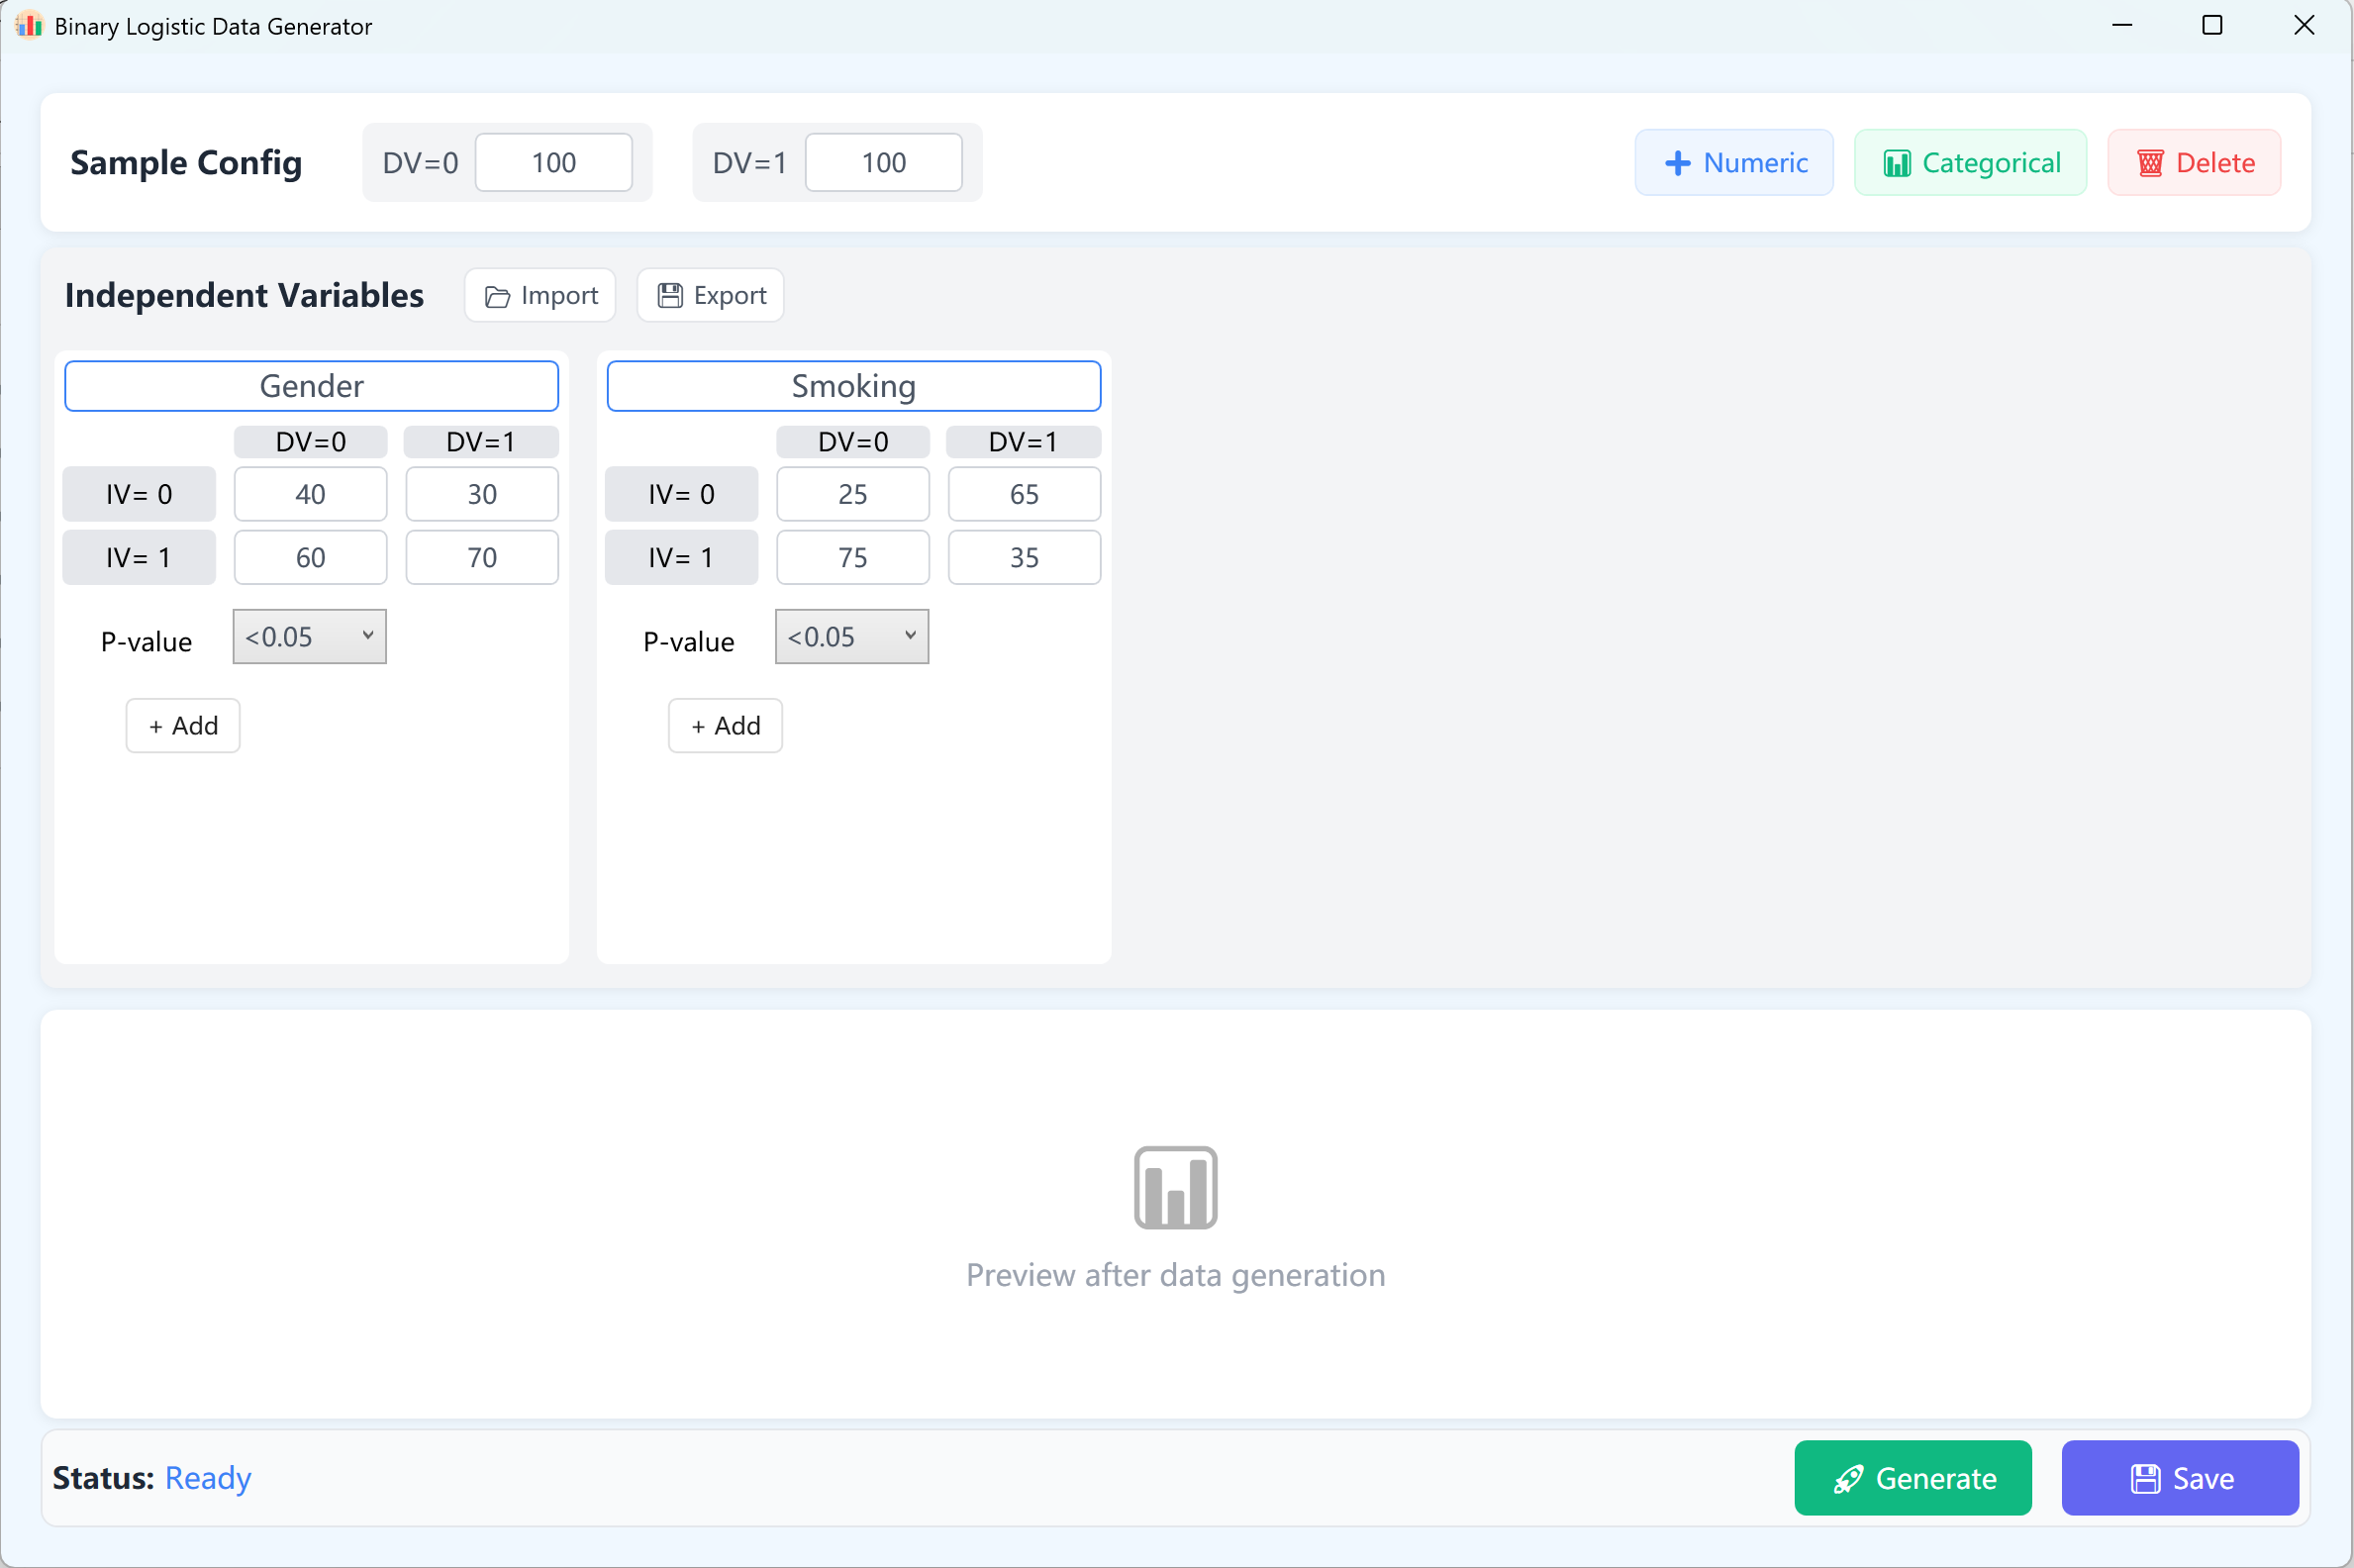
Рисунок 11.1: Настройка бинарной логистической регрессии
11.2 Генерация графиков Forest Plot и клинических прогностических моделей в один клик
После нажатия кнопки «Сгенерировать данные» (Generate Data) специальные кнопки в нижней части всплывающего окна результатов позволяют в один клик создать академические графики Forest Plot (с отображением отношений шансов OR и 95% ДИ в 8 стилях оформления ведущих журналов) и комплексные панели оценки клинических прогностических моделей (включая номограммы Nomogram, калибровочные кривые Calibration и анализ кривых принятия решений DCA).
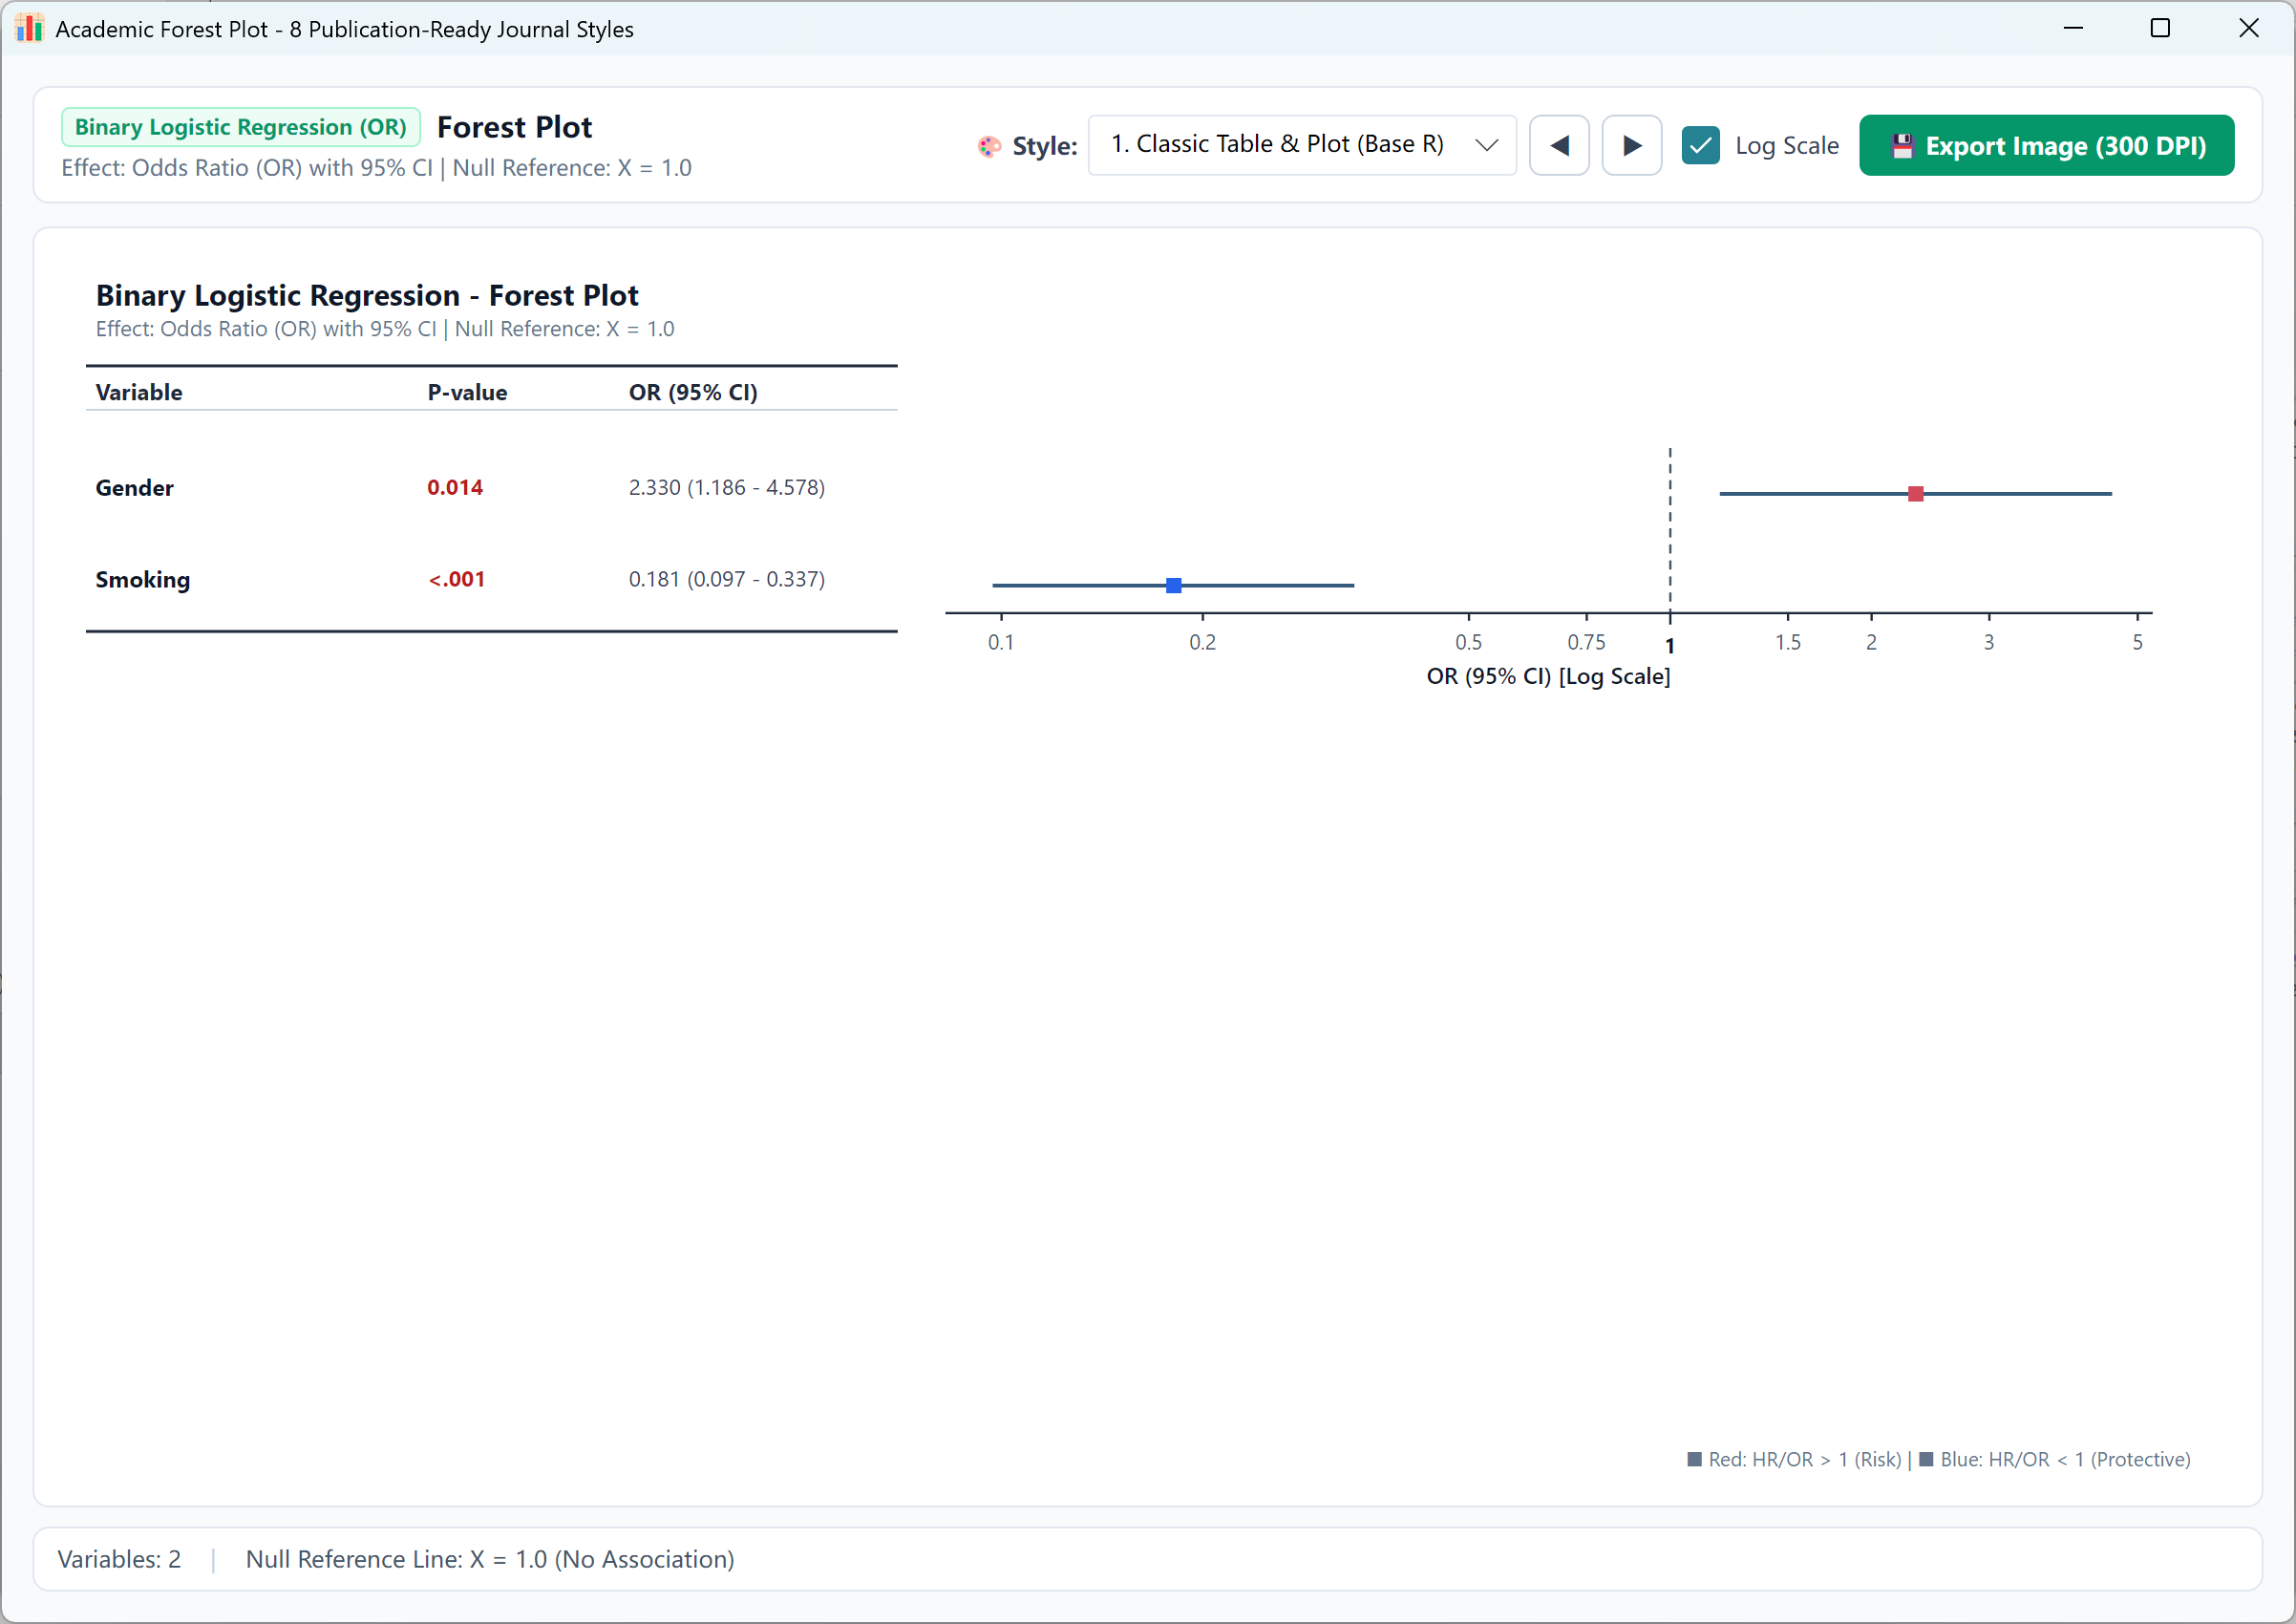
Рисунок 11.2: Академический Forest Plot для бинарной логистической регрессии (8 журнальных стилей)
.png)
Рисунок 11.3: Оценка клинической прогностической модели для бинарной логистической регрессии (номограмма, калибровка и DCA)
16. Генерация данных для множественной линейной регрессии
Основной инструмент прогнозного моделирования.
12.1 Рабочий процесс
Перейдите в Analyze → Regression → Linear Regression.
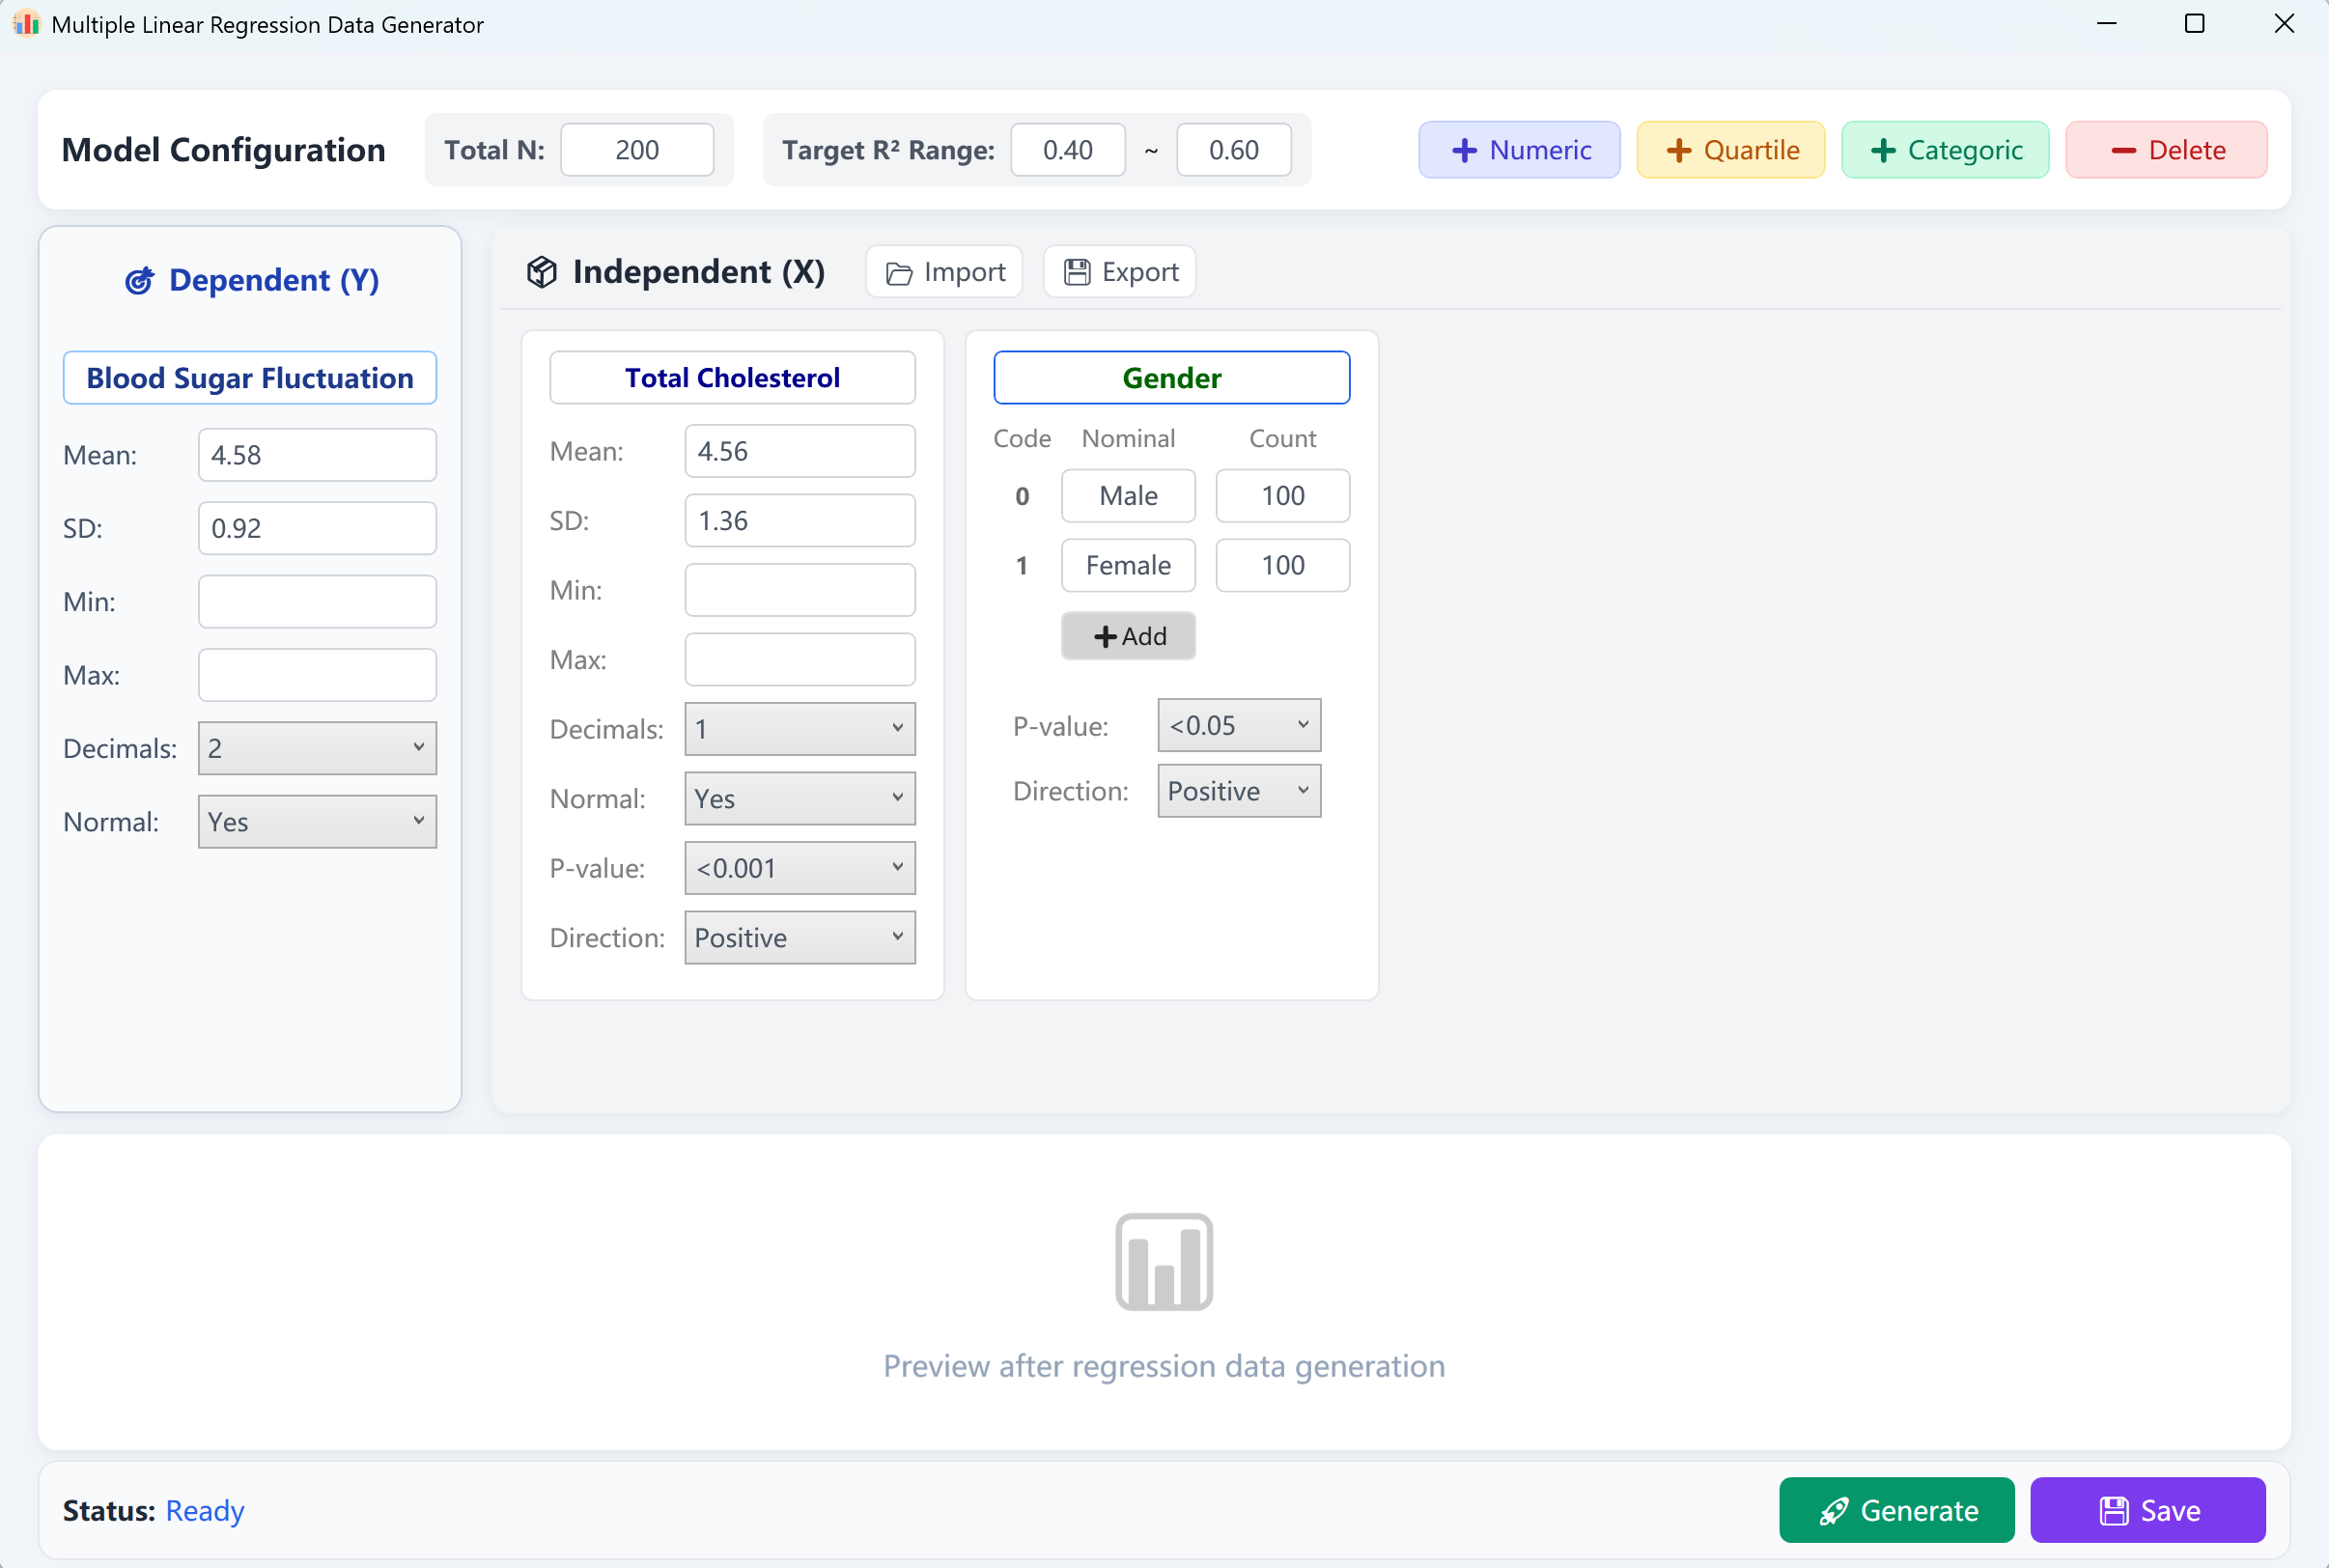
Рисунок 12.1: Настройка множественной линейной регрессии
12.2 Генерация графиков Forest Plot и клинических прогностических моделей в один клик
После генерации данных кнопки в нижней части окна результатов позволяют мгновенно построить академические графики Forest Plot (коэффициенты Beta и 95% ДИ), а также панели оценки прогностической модели (включая номограмму и диагностику качества модели).
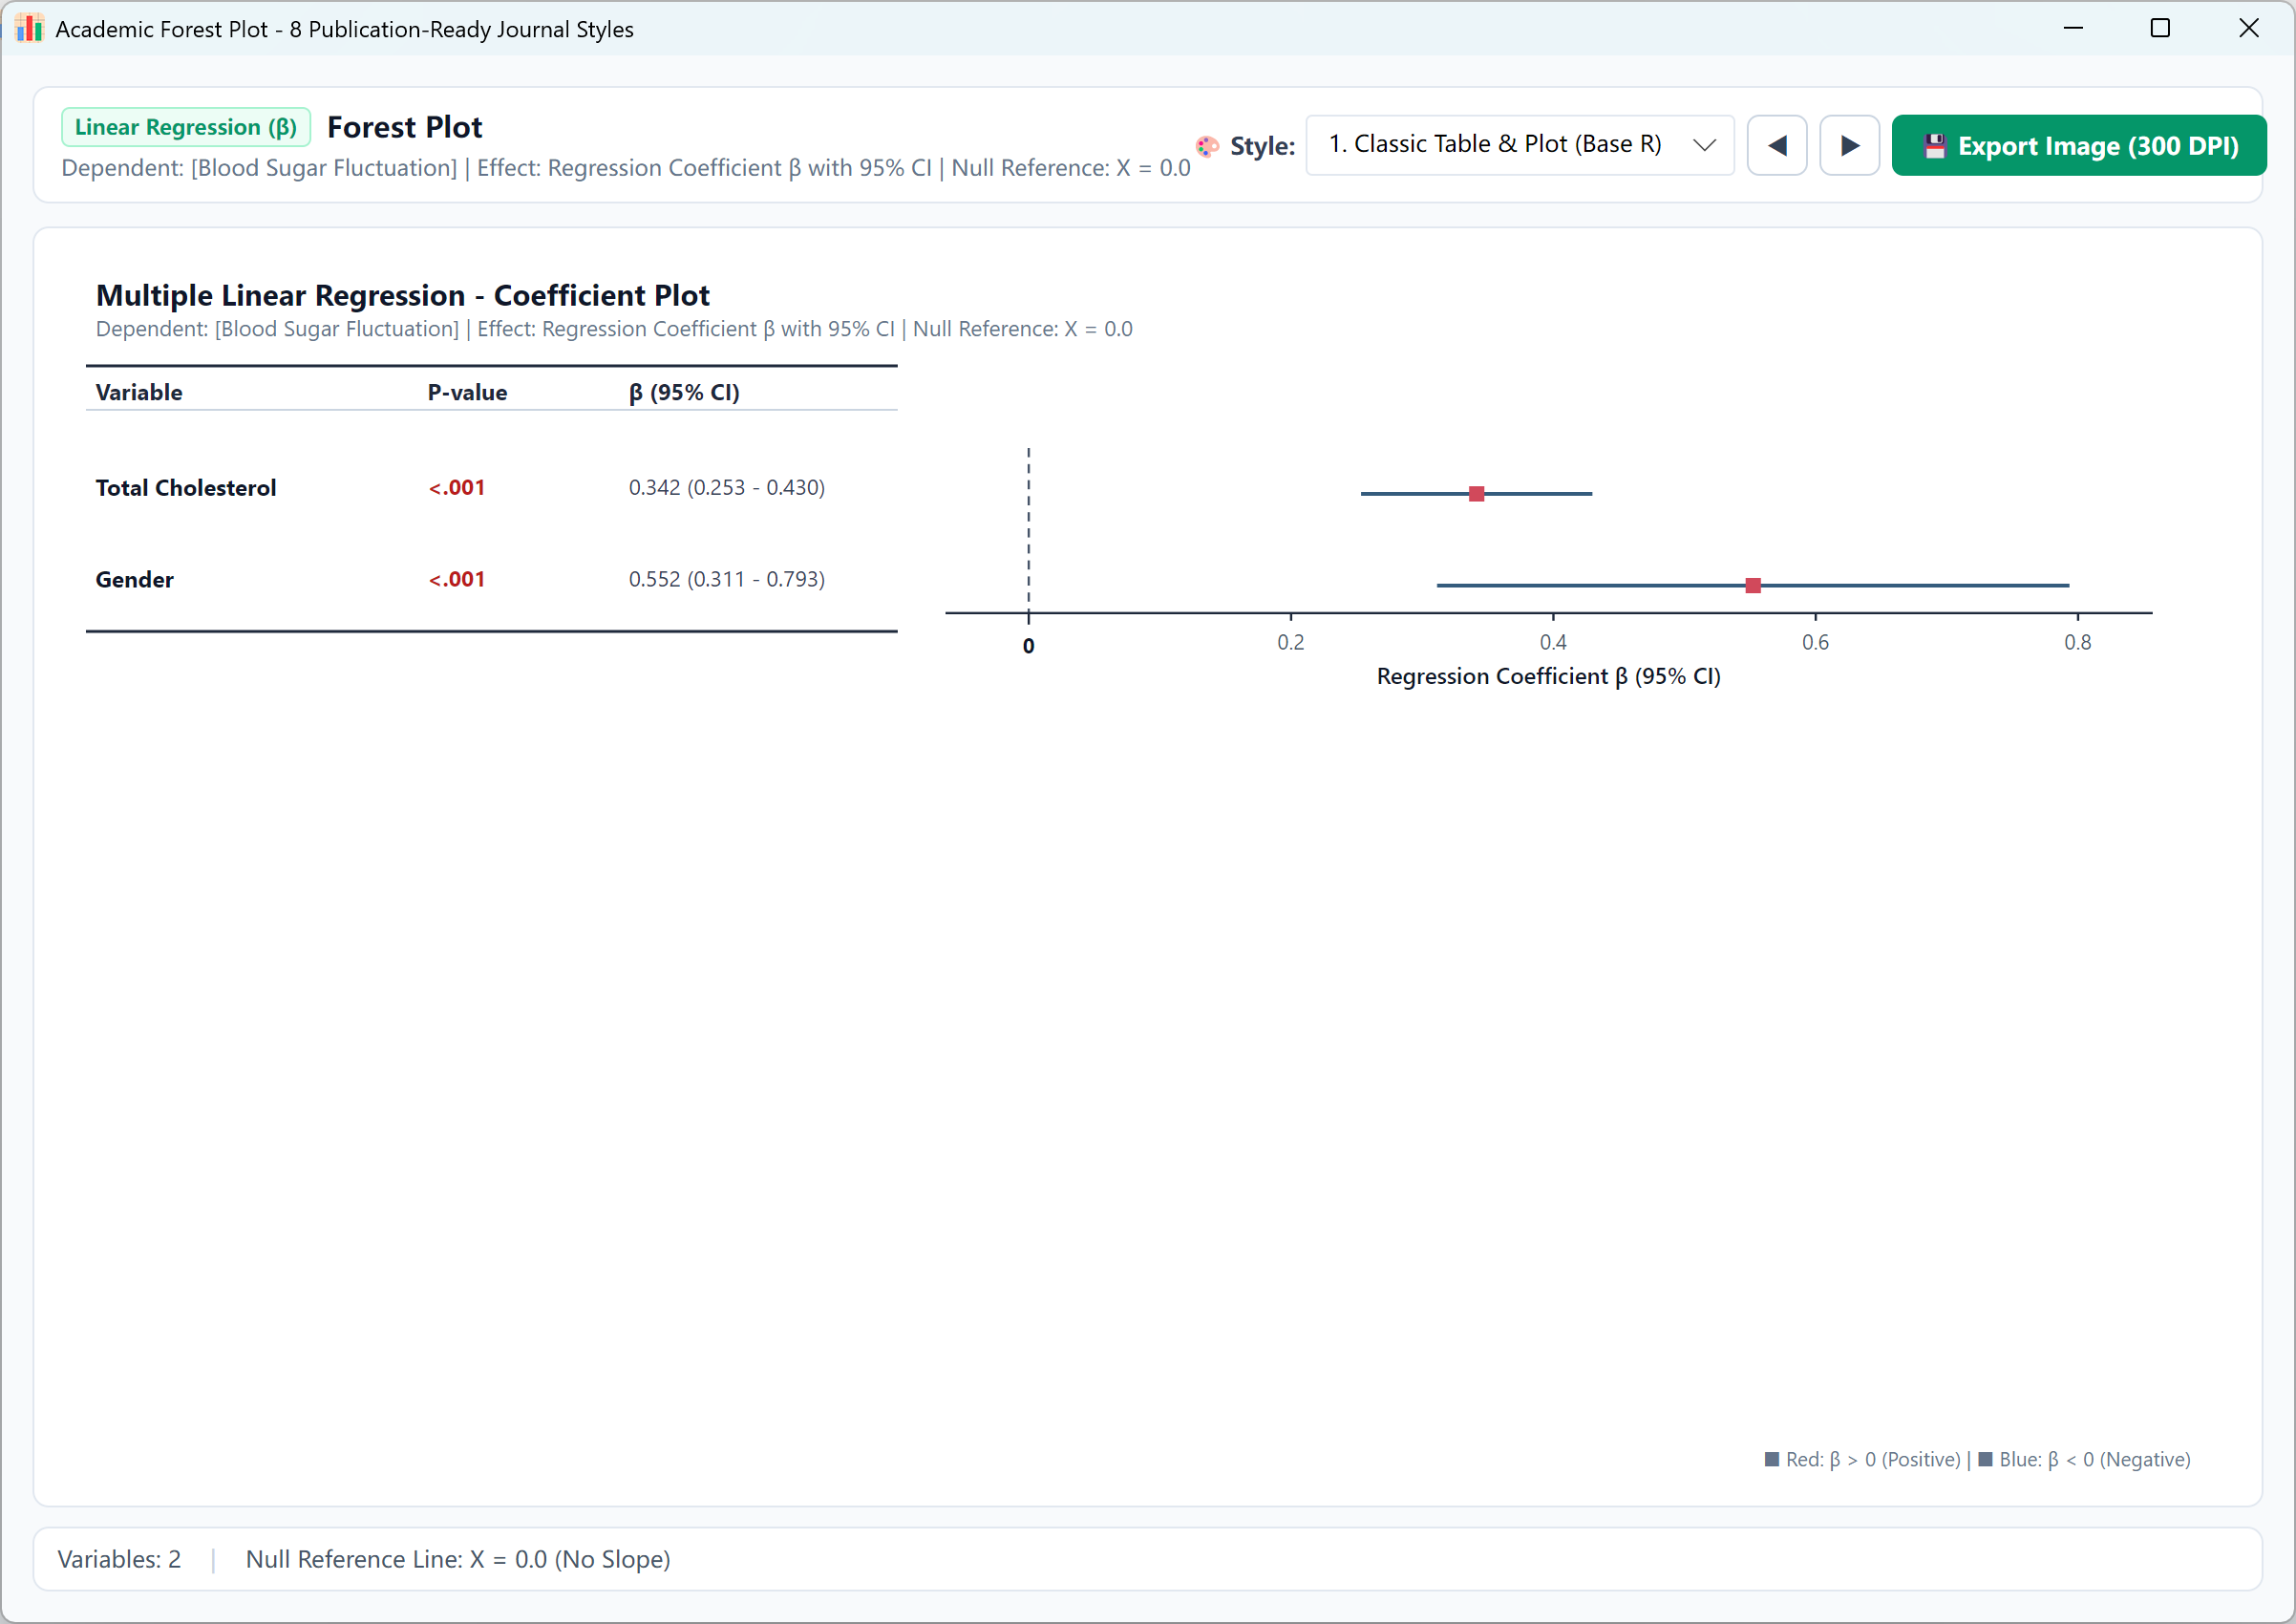
Рисунок 12.2: Академический Forest Plot для множественной линейной регрессии
-multiple linear.png)
Рисунок 12.3: Оценка клинической прогностической модели для множественной линейной регрессии (номограмма и диагностика)
17. Генерация данных для регрессии пропорциональных рисков Кокса
Золотой стандарт анализа выживаемости. Моделирует данные времени до события с учетом цензурирования справа.
13.1 Рабочий процесс
Перейдите в Analyze → Regression → Cox Regression.
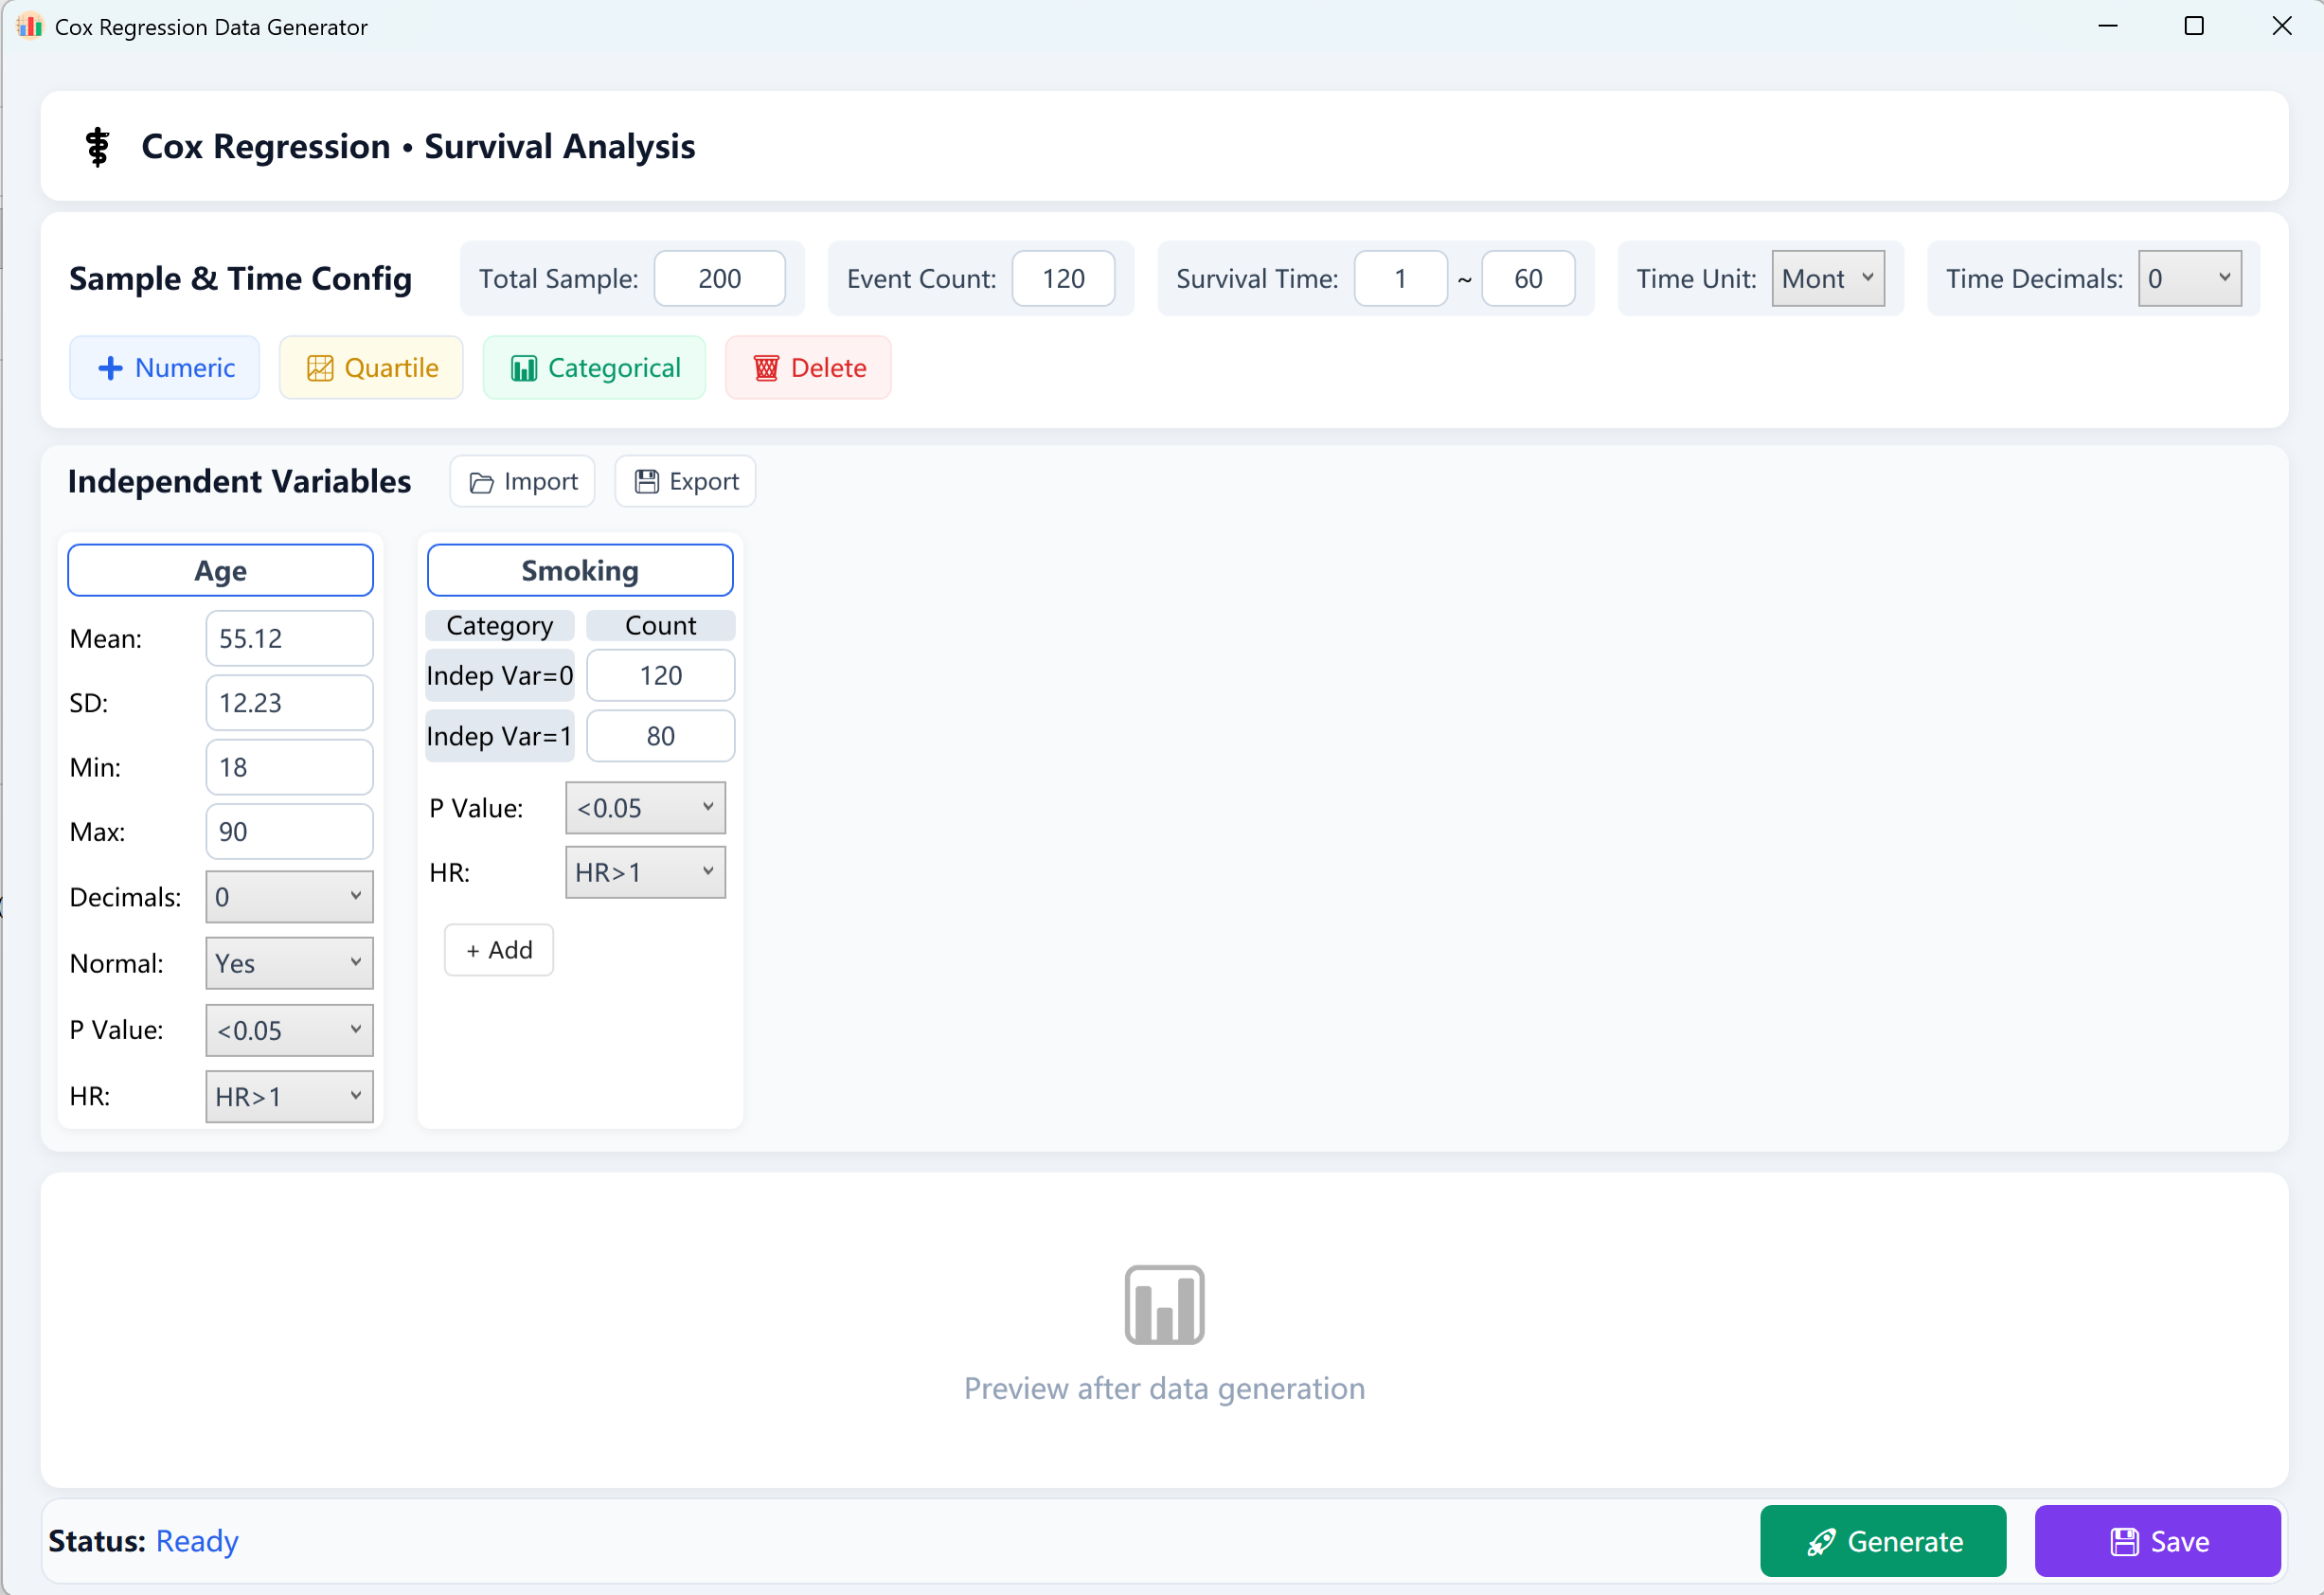
Рисунок 13.1: Настройка регрессии Кокса
13.2 Генерация графиков Forest Plot и клинических прогностических моделей в один клик
После симуляции данных выживаемости нажмите специальные кнопки в нижней части окна результатов для генерации академических графиков Forest Plot Кокса (отношения рисков HR и 95% ДИ) и панелей многомерных моделей выживаемости (включая зависящие от времени номограммы выживаемости на 1/3/5 лет, калибровочные кривые и DCA).
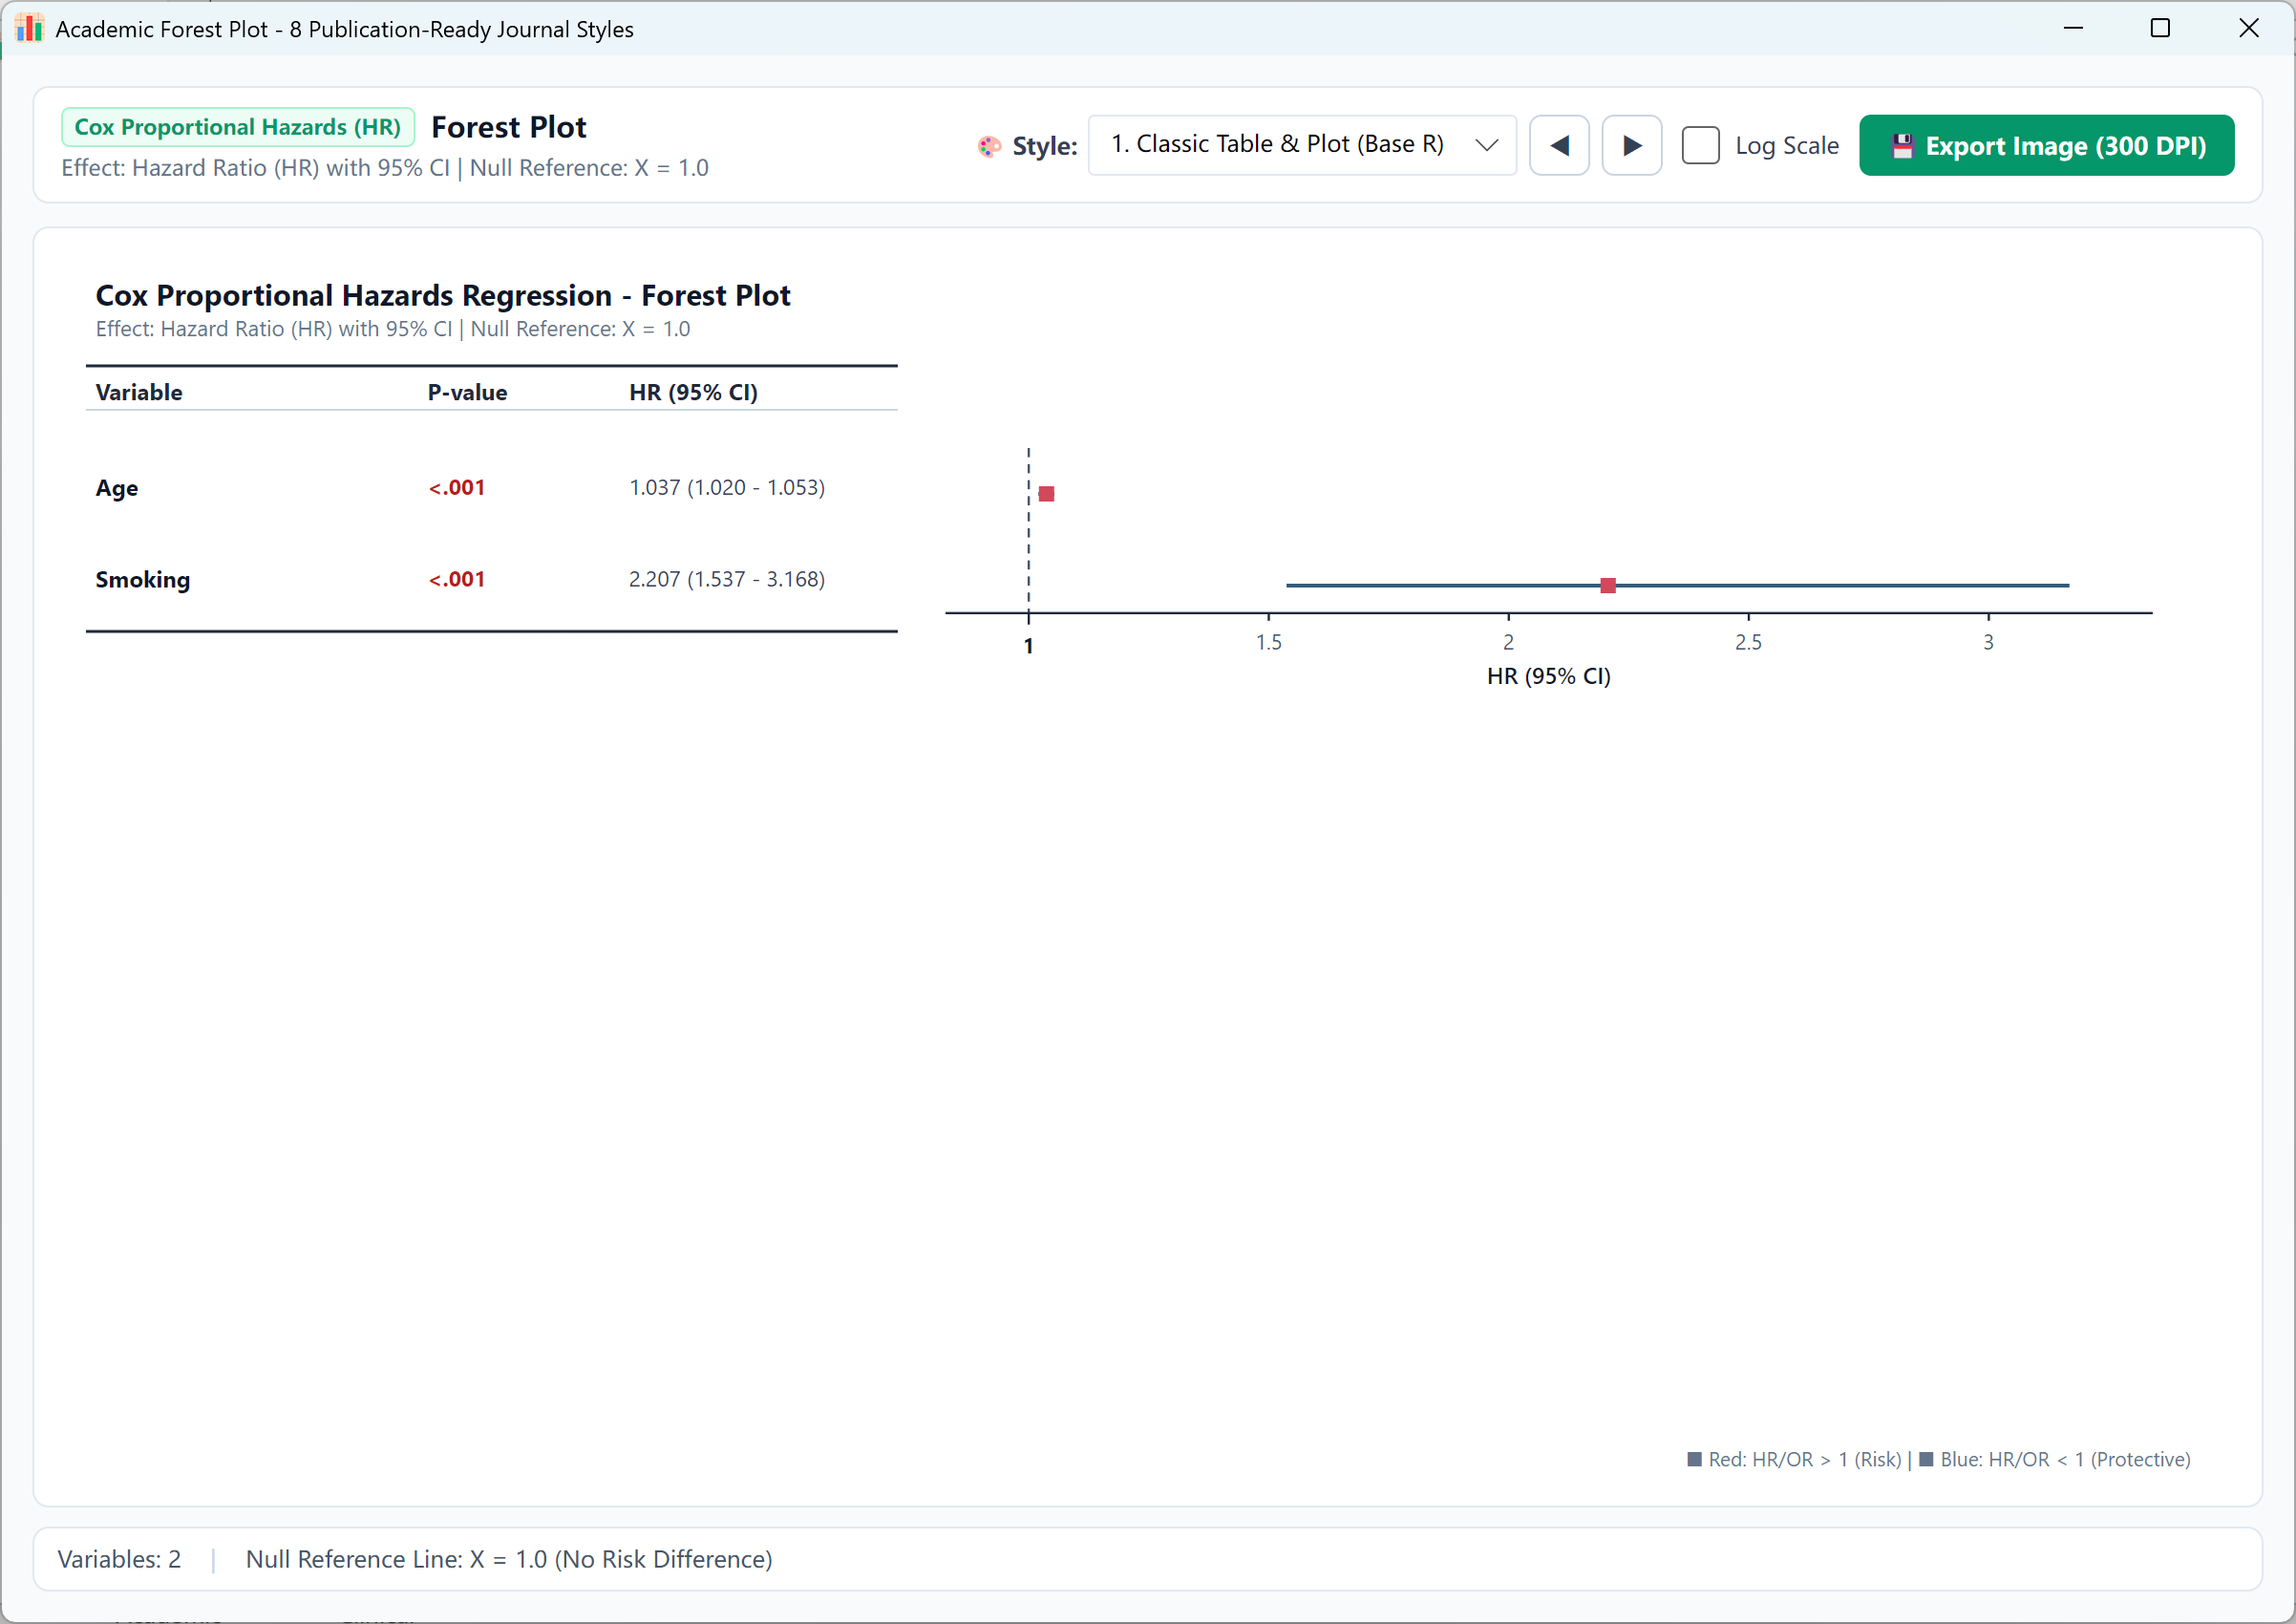
Рисунок 13.2: Академический Forest Plot для регрессии Кокса (коэффициенты риска HR и 95% ДИ)
-cox.png)
Рисунок 13.3: Оценка клинической прогностической модели для регрессии Кокса (номограмма выживаемости, калибровка и DCA)
18. Генерация данных для корреляционного анализа
Моделирует бивариантные связи (Пирсона или Спирмена) и частную корреляцию.
14.1 Рабочий процесс
Перейдите в Analyze → Correlation.
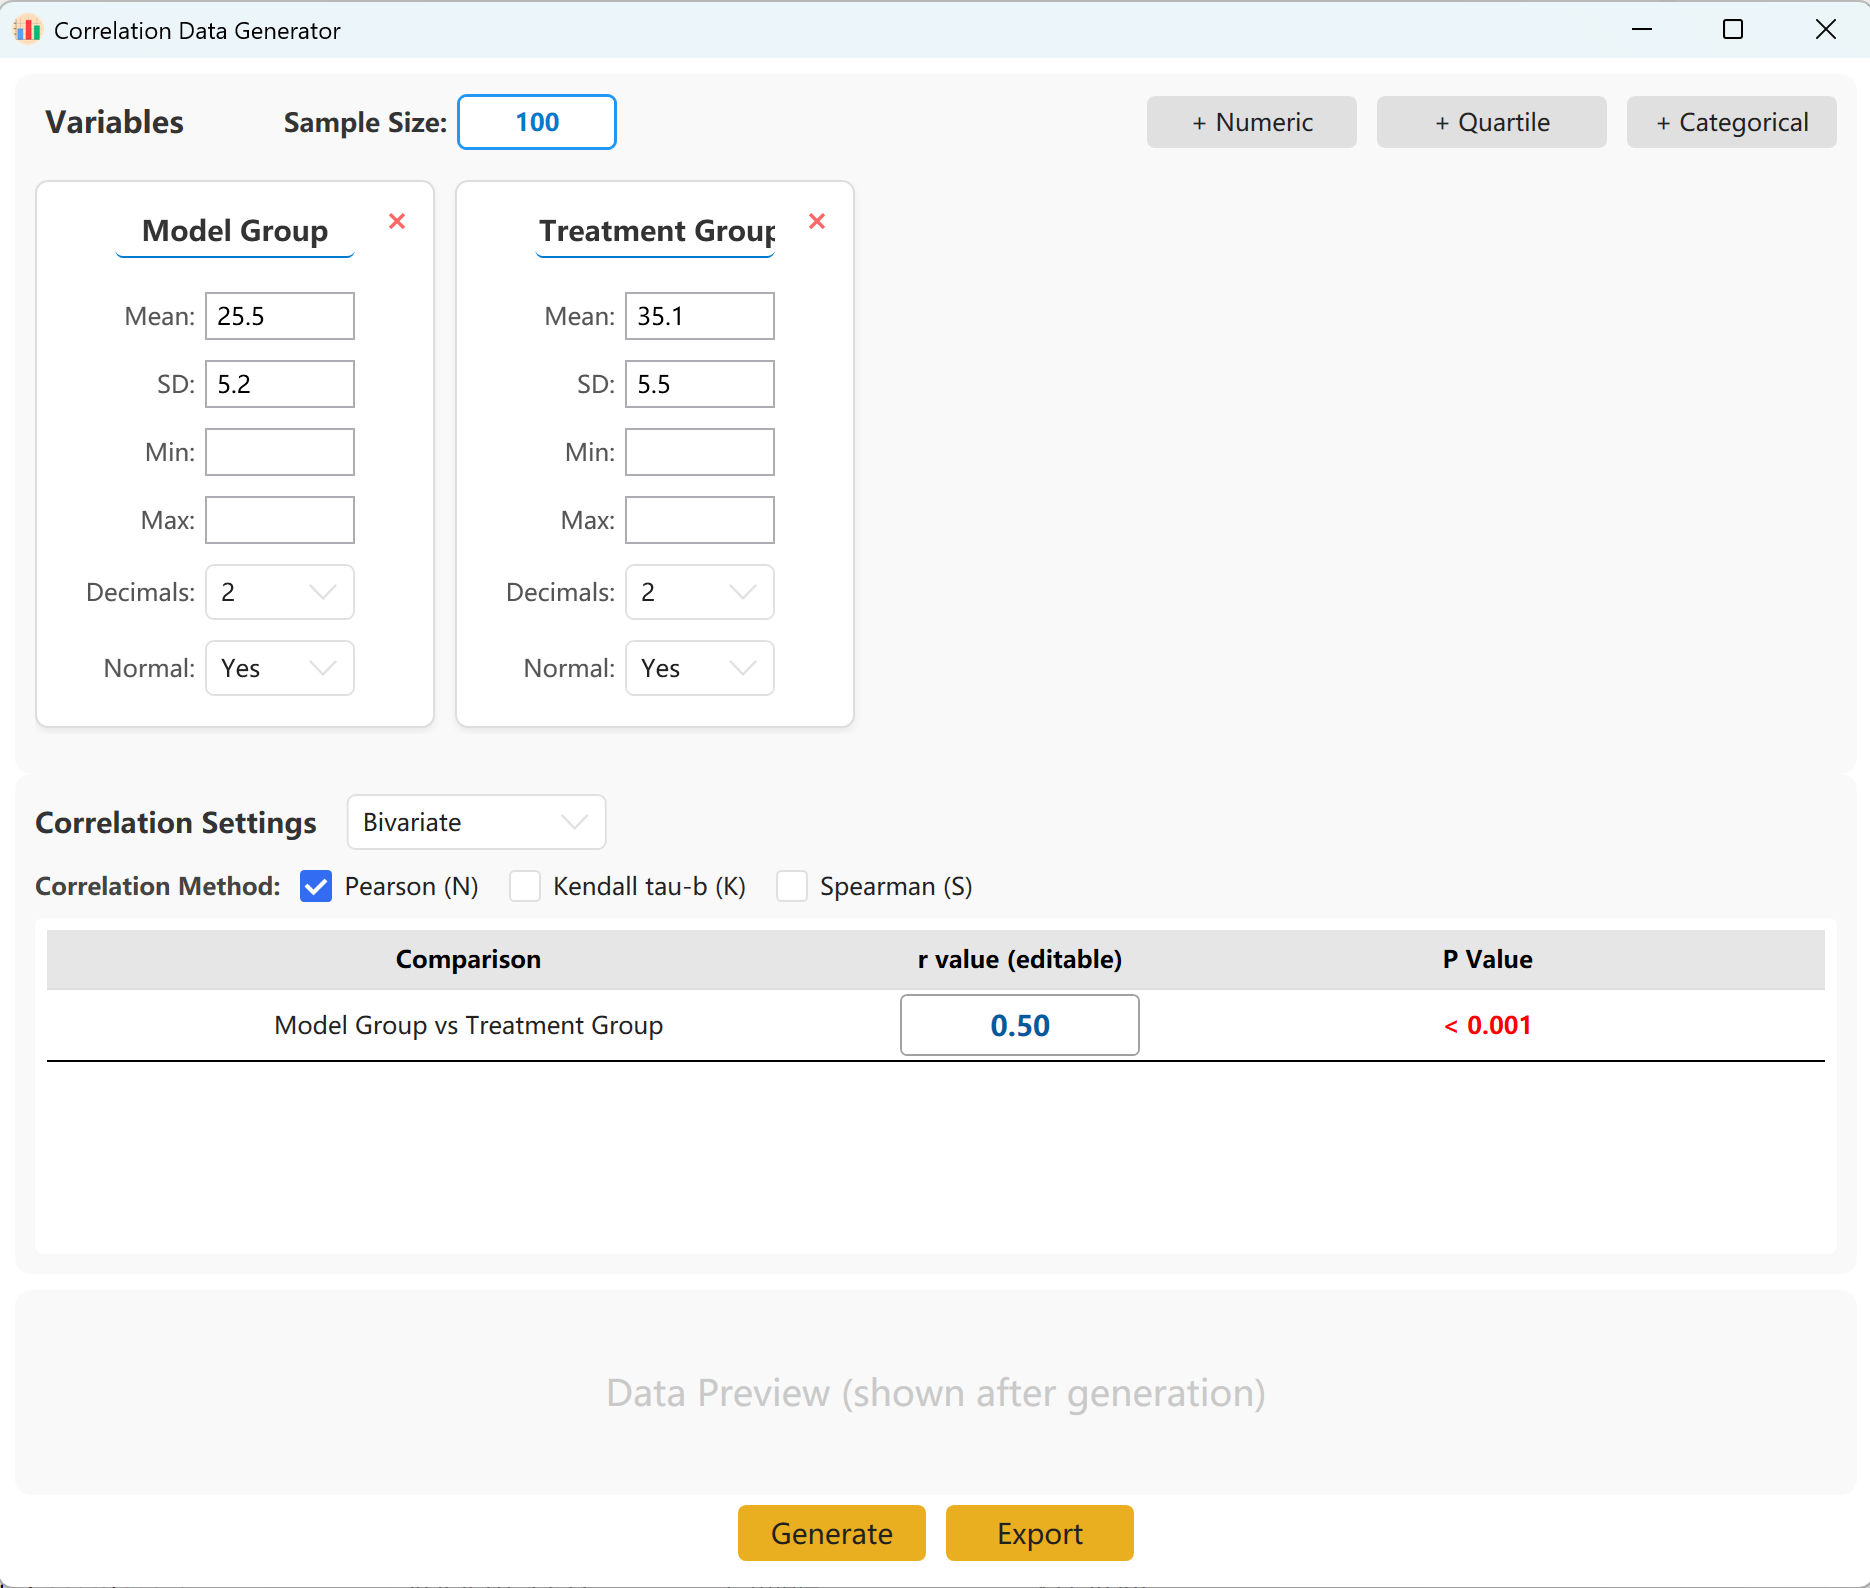
Рисунок 14.1: Настройка корреляционного анализа
19. Сравнение методов и анализ согласованности
Для клинических лабораторий и сопоставления измерительных приборов. Включает регрессию Пассинга-Баблока и анализ Бланда-Альтмана.
19.1 Порядок работы
Перейдите в меню Analyze → Method Comparison:
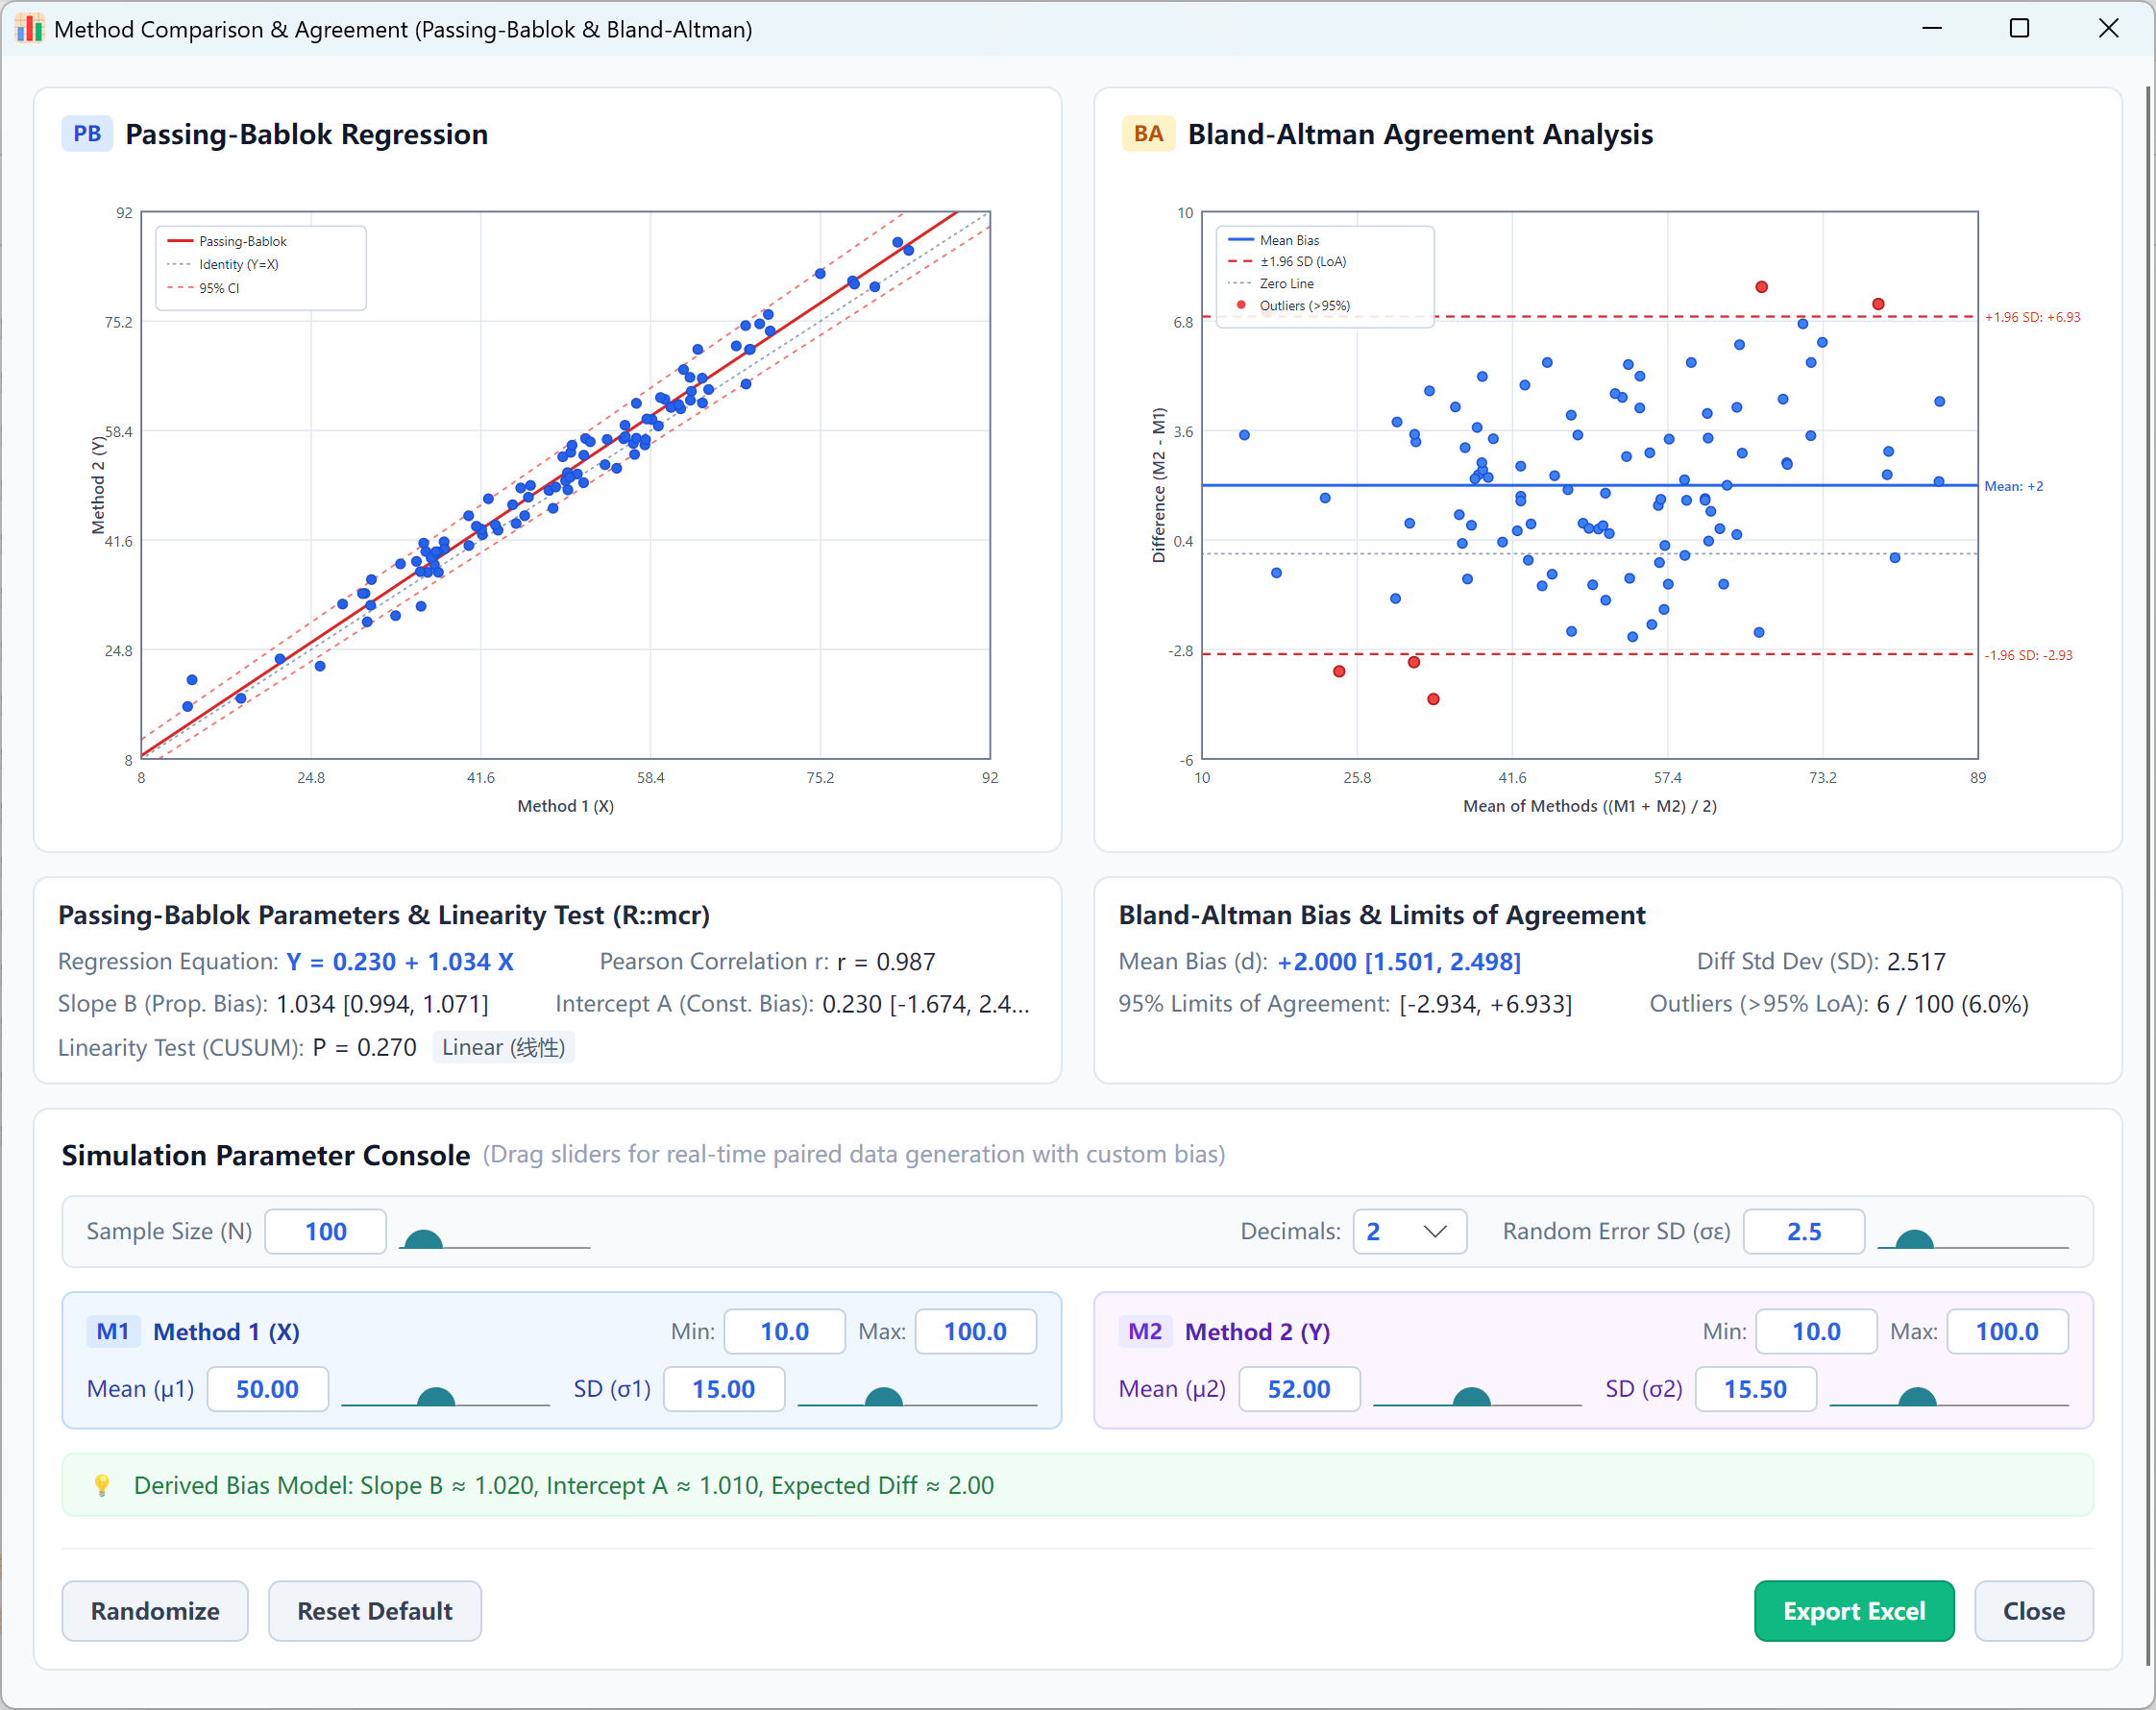
Рисунок 19.1: Интерфейс сравнения методов и согласованности
19.2 Методы анализа
- Регрессия Пассинга-Баблока (стандарт пакета R 'mcr'): Оценка наклона B, сдвига A, 95% доверительного интервала и теста линейности CUSUM.
- Анализ Бланда-Альтмана: Построение графика разностей, расчет среднего смещения (d), стандартного отклонения и 95% границ согласия (95% LoA = d ± 1.96 SD).
- Экспорт: Прямая выгрузка индивидуальных парных измерений в таблицы Excel.
20. Генерация данных для анализа ROC-кривых
Оценивает диагностическую способность тестовой переменной различать два состояния.
15.1 Рабочий процесс
Перейдите в Analyze → ROC Curve.
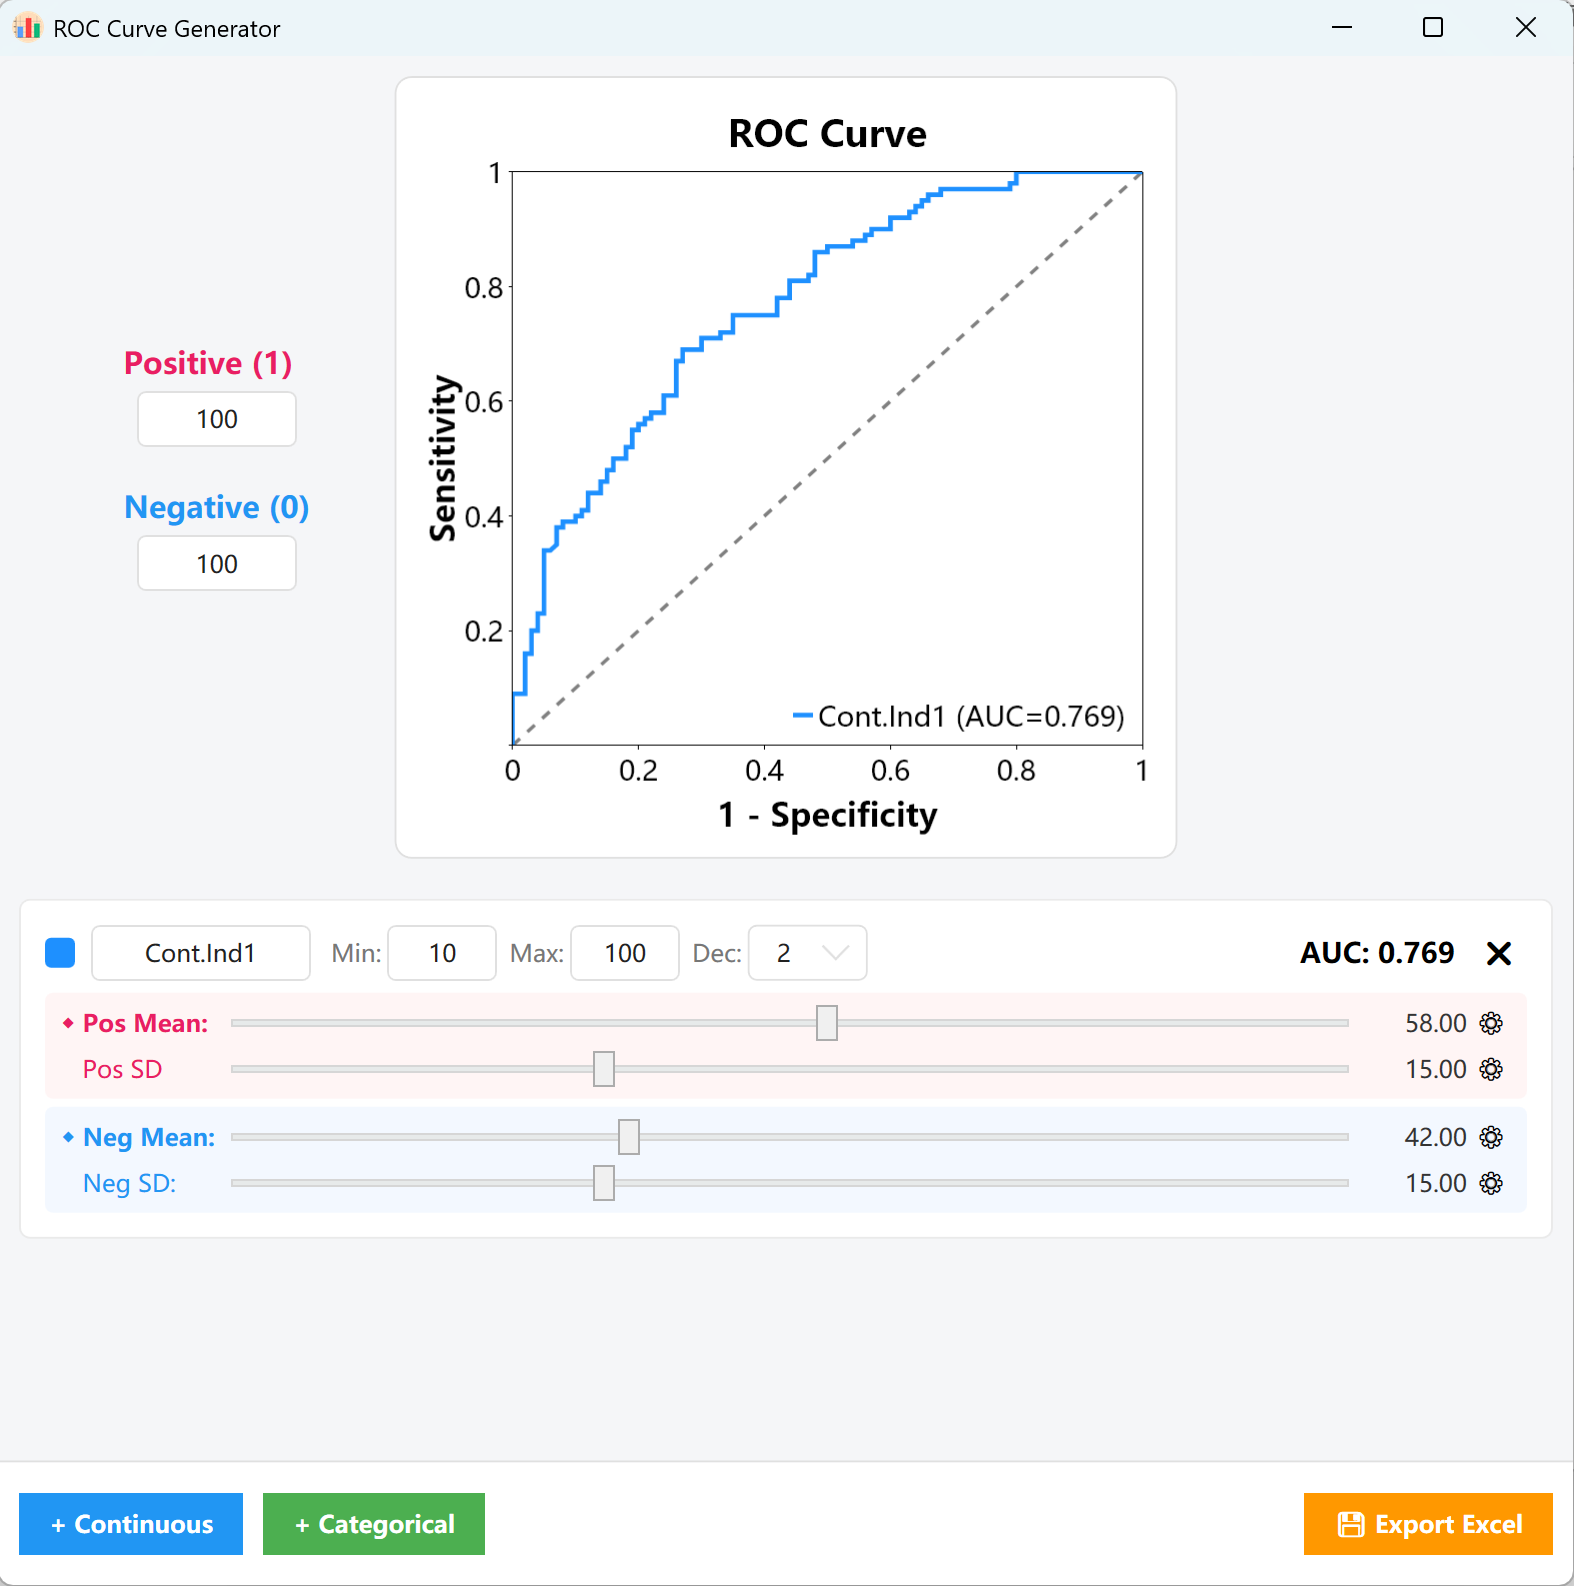
Рисунок 15.1: Настройка ROC-кривой
21. Анализ выживаемости Каплана-Мейера
Синтез когортных данных времени до события (Time-to-Event), настройка доли цензурирования, лог-ранговый тест и построение ступенчатых кривых.
21.1 Порядок работы
Перейдите в меню Analyze → Kaplan-Meier Curve:
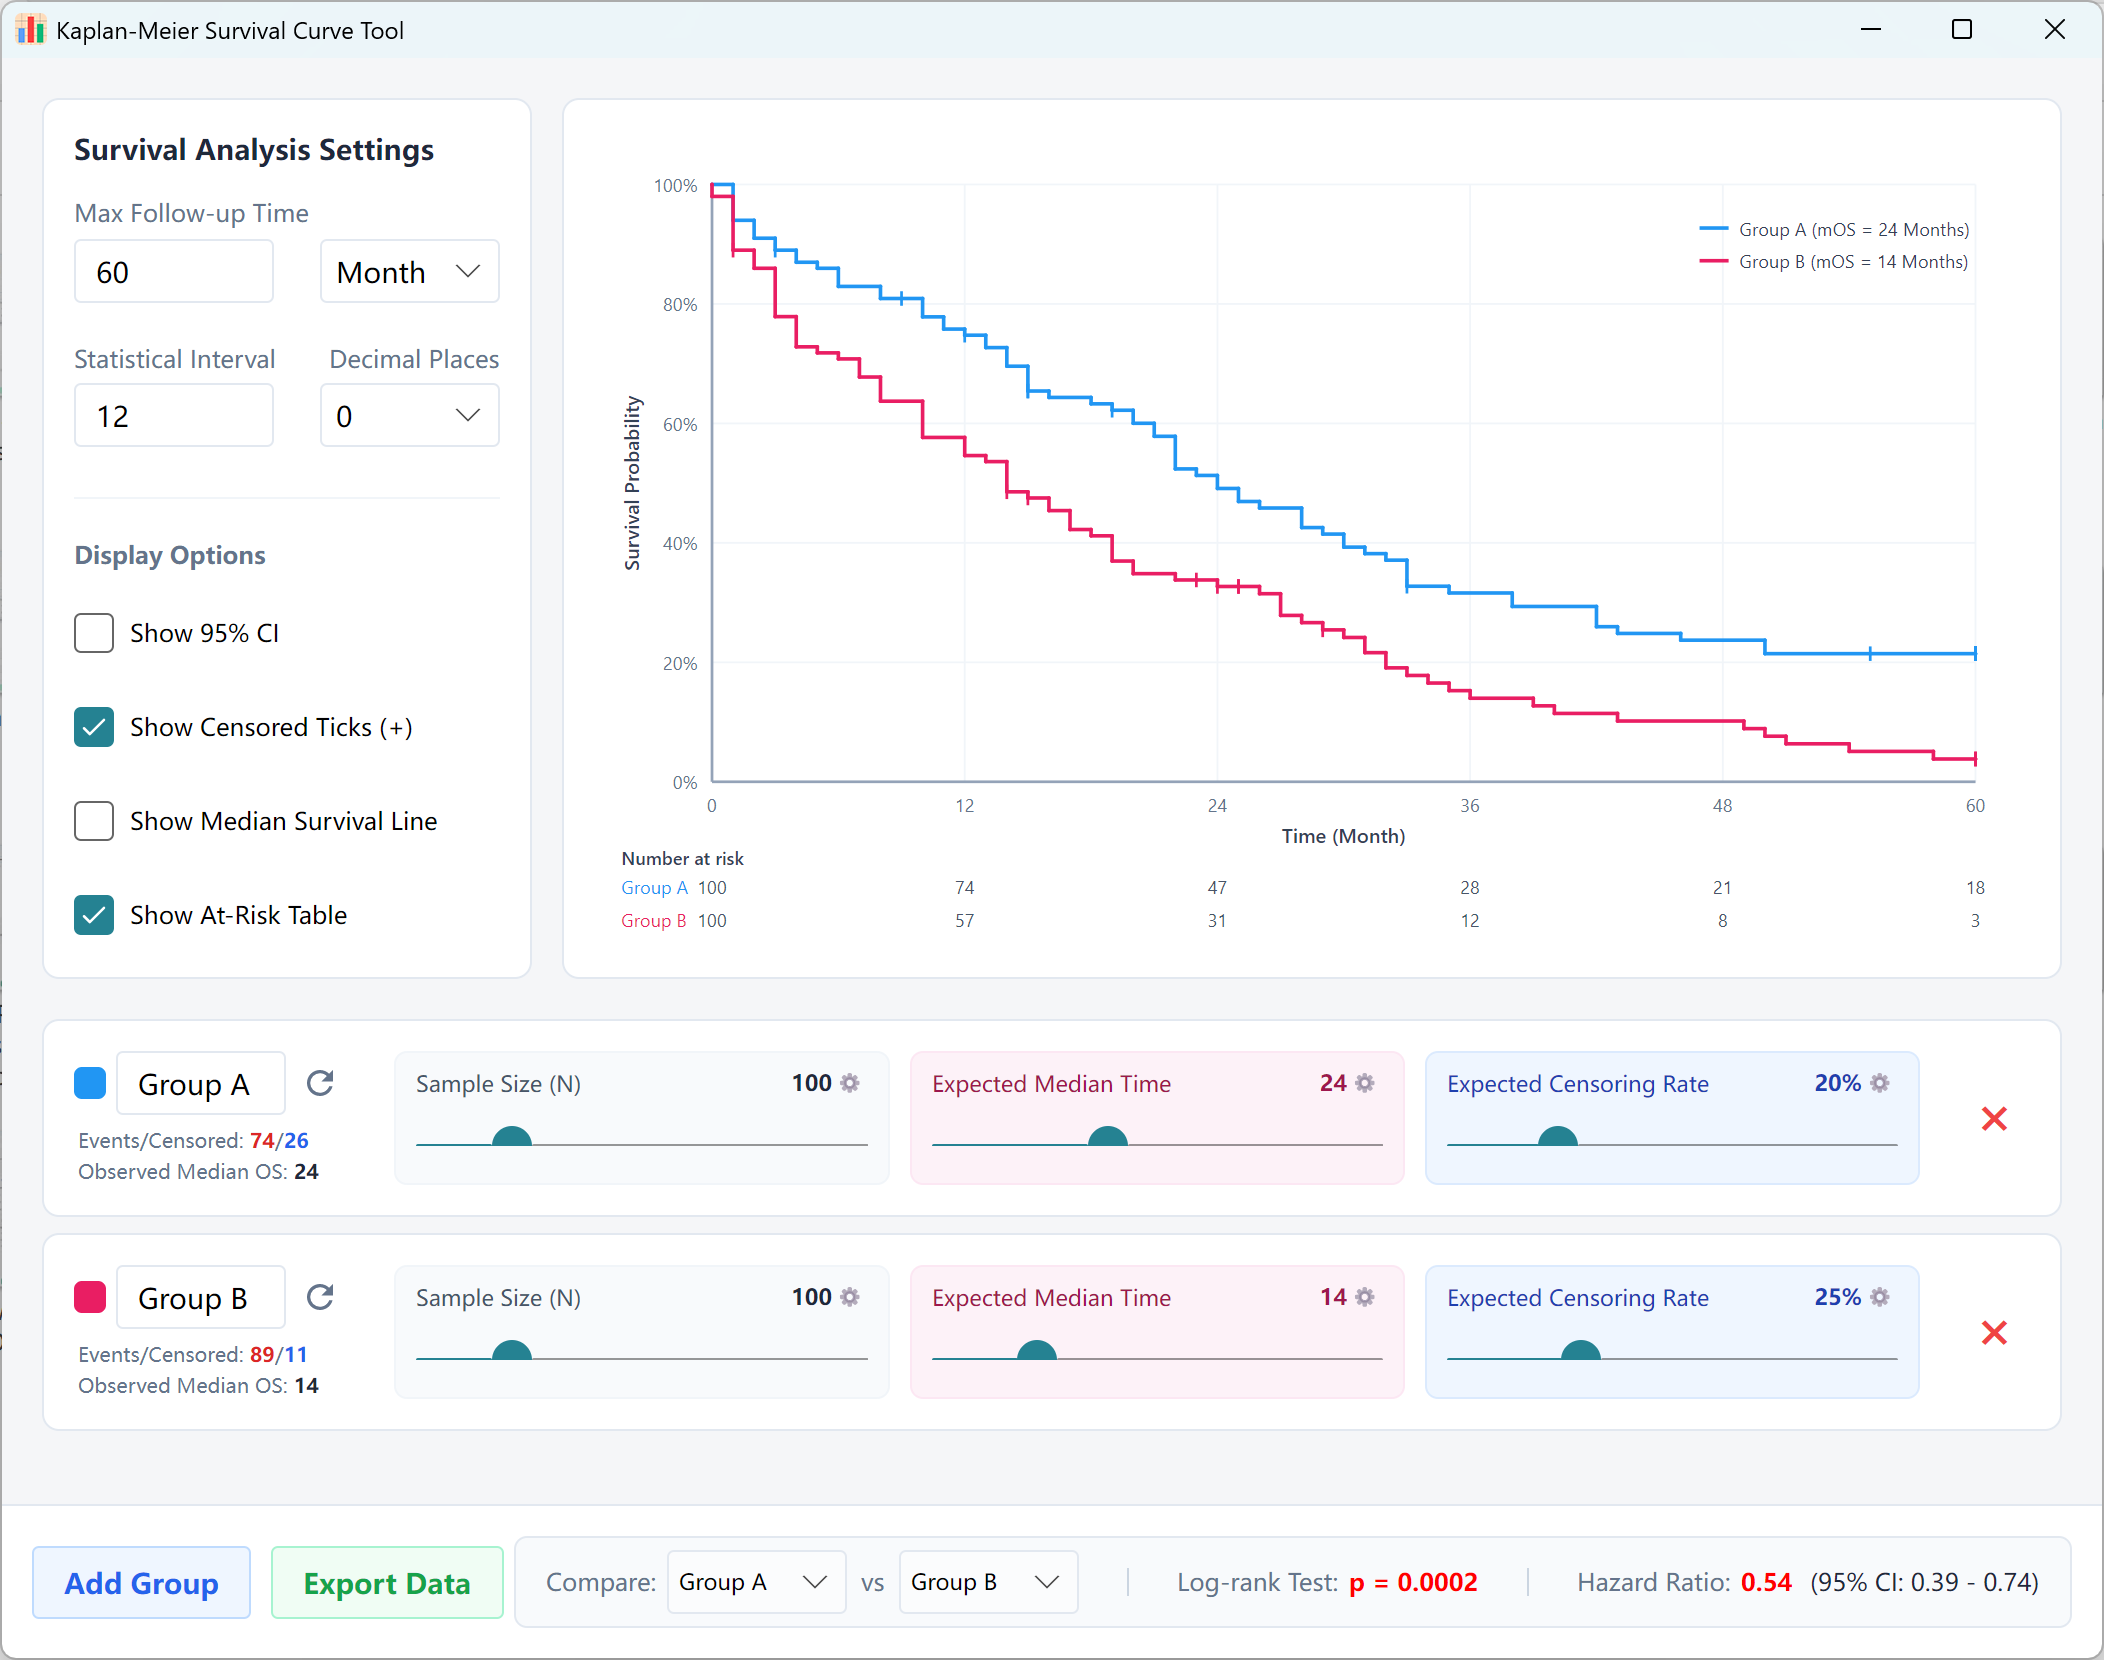
Рисунок 21.1: Интерфейс анализа выживаемости Каплана-Мейера
21.2 Настройки
- Параметры наблюдения: Максимальное время наблюдения, единицы измерения (месяц, день, год) и число знаков после запятой.
- Группы когорт: Размер выборки (n), ожидаемая медиана выживаемости и процент цензурирования (0%–100%).
- Статистика: Расчет лог-рангового критерия (Log-Rank Test) и отношения рисков (Hazard Ratio, HR с 95% ДИ).
- Экспорт: Сохранение исходных данных (.xlsx/.csv) и графиков высокого разрешения (.png).
22. Сохранение и экспорт настроек конфигурации
Для оптимизации повторяющихся задач моделирования приложение предоставляет мощный механизм сохранения состояния конфигурации.
16.1 Сохранение/Восстановление
- Экспорт конфигурации: Перейдите в File → Export Configuration для сохранения всех параметров в файл `.json`.
- Импорт конфигурации: Перейдите в File → Import Configuration и выберите ранее сохраненный файл конфигурации.